Forbereder Ami Pro-arkiver til AI og RAG-søgning
Årtier af institutionel viden ligger i et format, som ingen model kan læse. Her er den proces, der ændrer det — og hvorfor konverteringstrinnet afgør, hvor god hele systemet vil være.
TL;DR
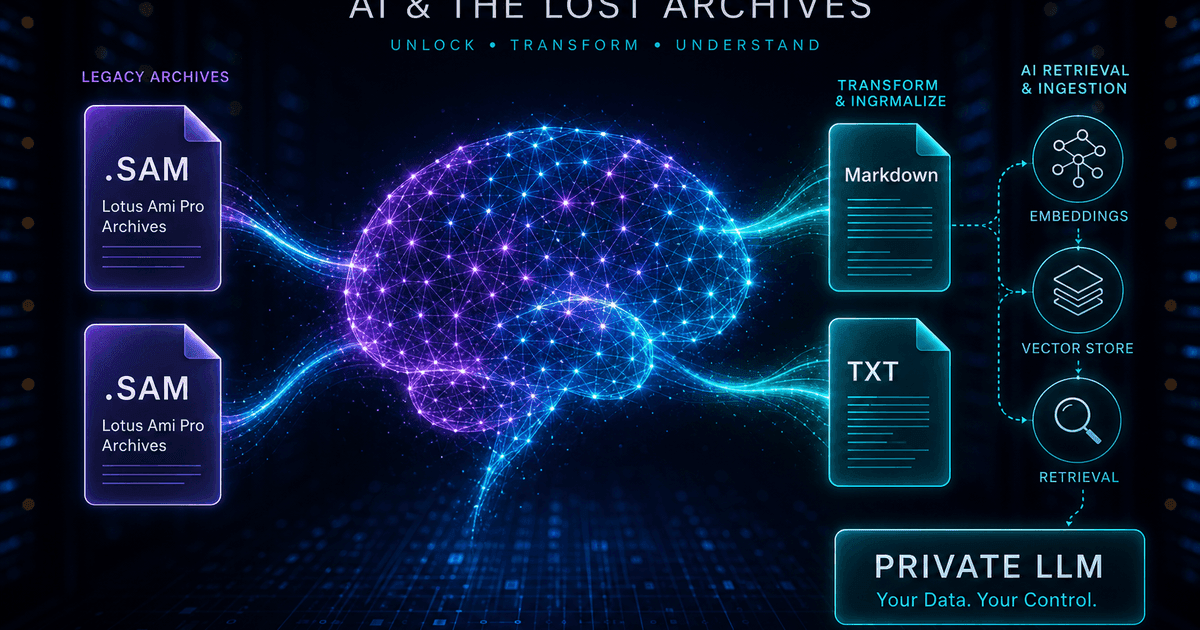
For en sprogmodel eksisterer dit Ami Pro arkiv ikke. Konverter det til Markdown i stedet for PDF: overskrifter bevares som struktur, som en opdelingsværktøj kan splitte på, tabeller forbliver læselige, ligninger ankommer som LaTeX, og du undgår den ekstraktionsstøj, som PDF-pipelines introducerer. Opdel efter overskrift, vedhæft metadata til filtrering, indlej lokalt, og hold hele processen offline — den samme fortrolighed, der gør et privat RAG-system værd at bygge, gælder også for konverteringstrinnet. Start med Ami Pro Converter.
Det usynlige korpusproblem
Organisationer, der bygger interne AI-assistenter, opdager som regel den samme kløft. Systemet besvarer spørgsmål om alt skrevet de sidste femten år og bliver tomt på alt, der er ældre, fordi det ældre materiale er i formater, som ingen indtagningspipeline kan læse. For institutioner, der brugte Ami Pro i begyndelsen af 1990'erne, kan det betyde, at hele grundlæggelsesperioden for en politik, et produkt eller en juridisk position mangler.
Konsekvensen er mere subtil end et ufuldstændigt indeks. Et søgesystem, der tavst mangler historisk kontekst, siger ikke "Jeg har ikke det"; det svarer ud fra det, det har, med sikkerhed, og svaret udelader den ræsonnement, der har formet alt siden. Ingen bemærker det, fordi hullet er usynligt udefra.
At konvertere det gamle arkiv er derfor ikke en oprydningsøvelse. Det er forskellen mellem en assistent, der ved, hvorfor beslutninger blev truffet, og en, der kun kender den nuværende tilstand.
Hvorfor Markdown, ikke PDF
Instinktet er at konvertere alting til PDF, fordi PDF er standarden for arkivering, og derefter køre PDF-ekstraktion i pipelinen. Dette er den mest almindelige selvpåførte skade i RAG-projekter med ældre indhold, fordi man konverterer struktur til layout og derefter betaler for at gætte strukturen tilbage.
PDF-ekstraktion genintroducerer alle layoutartefakter som støj: forvirring omkring kolonneordning, løbende overskrifter og sidefødder, der dukker op midt i afsnit, bindestreger, der deler ord på linjeskift, og tabeller, der kollapser til strømme af tal uden række- eller kolonneforbindelse. Modellen ræsonnerer derefter over det rod.
Markdown går den anden vej. Fordi Ami Pro dokumenter bærer eksplicit stilinformation i deres .STY-ark, kan overskrifter udgives som rigtige Markdown-overskrifter, lister som lister og tabeller som pipe-tabeller. Din chunker får ægte struktur, dine embedding får ren tekst, og du bruger intet på udtrækningsheuristikker.
En pipeline, der virker
1. Lav en opgørelse over arkivet
Find alle .sam filer inklusive store bogstaver .SAM varianter, bekræft, at .STY stilarkene er til stede, og registrer antallet. Uden stilark mister dit Markdown overskriftsstrukturen, hvilket er det ene, du konverterer for.
2. Konverter til Markdown, og TXT til triage
Udsend begge på én gang. Markdown leverer indekset; almindelig tekst giver dig en hurtig måde at søge i korpuset på, finde næsten-duplikater og identificere tomme eller skabelondokumenter, før du bruger indlejringbudget på dem.
3. Opdel efter overskrift, ikke efter antal tegn
Faststørrelsesopdeling skærer igennem midten af argumenter. Del på overskriftsgrænser med en beskeden overlapning, så hver del er en sammenhængende enhed, og før overskriftsstien med ind i delens tekst, så hentning ved, hvor den kommer fra.
4. Vedhæft metadata til filtrering
Tag hver del med kildefilnavn, dokumentdato, afdeling og mappesti. Historiske korpora gør metadatafiltrering afgørende — "hvad sagde politikken i 1996" er et filter plus en søgning, ikke kun en søgning.
5. Indlejre og indeksere lokalt
Kør en lokal embeddingsmodel og gem vektorer i pgvector, Chroma, Qdrant eller lignende. Hvis fortrolighed er grunden til, at du bygger et privat system, underminerer det formålet at sende korpuset til en hostet embeddings-API.
Hvad gør arkiverede dokumenter specielle at indeksere
Gamle dokumenter er tætte med henvisninger til ting, der ikke længere eksisterer: afløste afdelingsnavne, ophørte produktkoder, tidligere stillingstitler, forældede regelsystemnumre. En model kan ikke løse disse på egen hånd, og en bruger, der stiller et moderne spørgsmål, vil ikke bruge det historiske ordforråd.
Den billige afbødning er en lille ordliste indsat i systemprompten, som kortlægger gamle navne til de nuværende. Det koster næsten ingenting og forbedrer markant genkaldelsen på en historisk korpus.
Den anden karakteristik er, at ældre dokumenter ofte bliver erstattet, men ikke markeret som sådan. En procedure fra 1994 og dens erstatning fra 2003 virker lige autoritative for et hentningssystem. Dato-metadata plus en eksplicit instruktion om at foretrække nyere kilder og at angive datoen for ethvert historisk svar forhindrer den mest skadelige fejltilstand: at citere en ophævet politik som aktuel.
Tabeller og ligninger i en AI-pipeline
Tabeller er, hvor valg af format giver mest synligt udbytte. En Markdown rørbord bevarer sammenhængen mellem en værdi, dens kolonneoverskrift og dens rækkemærkat, så en model kan besvare spørgsmål om en specifik celle. Den samme tabel udtrukket fra en PDF er ofte en sekvens af tal med overskrifterne adskilt — og en model, der bliver bedt om at fortolke den, vil gætte.
Ligninger opfører sig på samme måde. Gjenvundet som gengivne billeder er de usynlige for tekstsøgning og for modellen; gjenvundet som LaTeX er de søgbare, indlejrede og gen-gengivelige. For tekniske arkiver — ingeniørberegninger, videnskabelige artikler, aktuarielle noter — er LaTeX-ekstraktion det, der gør korpuset virkelig søgbart fremfor blot til stede.
Hvor et dokument er grundlæggende visuelt, accepter det. Konverter det til PDF for menneskelig læsning, indekser den tekst, det måtte indeholde, og registrer i metadataene, at indholdet er grafisk, så søgning kan henvise en person til originalen i stedet for at forsøge at opsummere den.
Hold hele rørsystemet offline
De fleste private RAG-projekter eksisterer netop fordi materialet ikke kan gå til en tredjepart. Det er værd at bemærke, når konverteringstrinnet stille og roligt bryder den regel: at bruge en web-baseret konverter til at forberede dokumenter til et system, hvis hele formål er fortrolighed, er en modsætning, der har tendens til at overleve, fordi konvertering behandles som VVS frem for som behandling.
En lokal desktop-konverter bevarer kæden af ejerskab intakt fra .sam-filen til vektor-lageret. Intet overføres, så der er ingen overførsel at vurdere eller dokumentere, og arbejdsprocessen kan køre på en isoleret arbejdsstation, hvis det er, hvad materialet kræver.
Kombiner det med en lokal indlejringsmodel og en selv-hostet vektordatabase, og du har et system, du ærligt kan beskrive i en compliance-gennemgang: korpuset forlod aldrig netværket på noget tidspunkt.
Derfor slår Markdown først PDF først til RAG
- Overskrifter bevares som struktur, så opdelingen følger dokumentets egen logik
- Tabeller bevarer forbindelsen mellem overskrift og værdi, som PDF-udtræk ødelægger
- Ligninger kommer som LaTeX – søgbare og maskinlæsbare, ikke billeder
- Intet OCR- eller layoutgenskabelsestrin, så færre tokens og mindre støj
- Hele processen forbliver offline og bevarer den fortrolighed, der begrundede den
Årtier af kontekst, endelig søgbar
De mest værdifulde dokumenter i en organisation er ofte de ældste, fordi de registrerer, hvorfor tingene er, som de er. At lade dem være i et format, som ingen kan læse, betyder, at dit AI-system kender nutiden og ingenting af begrundelsen bag den.
Konverter arkivet til Markdown med de anvendte stilark, opdelt efter overskrifter, mærk med datoer og afdelinger, indlej lokalt, og fortæl modellen at være eksplicit om hvor gamle dens kilder er. Korpusset går fra usynligt til søgbart, og det forlader aldrig dit netværk.
Konverter dine filer
Relateret læsning
Gør dit Ami Pro-arkiv AI-læsbart
Gratis prøveperiode konverterer op til 10 .sam filer til Markdown med LaTeX-ligningsekstraktion — test din opdeling, før du forpligter dig til hele korpuset.
Gratis prøveversion
Alle app-funktioner — op til 10 filer
Windows 10 eller 11
Hent Windows-installationsprogram til den fulde 10-filers prøveversion. Samme app, som du låser op med en licens — 100 % lokalt på din PC.