Preparando los Archivos Ami Pro para Búsqueda de IA y RAG
Décadas de conocimiento institucional se encuentran en un formato que ningún modelo puede leer. Aquí está el proceso que cambia eso, y por qué el paso de conversión decide qué tan bueno será todo el sistema.
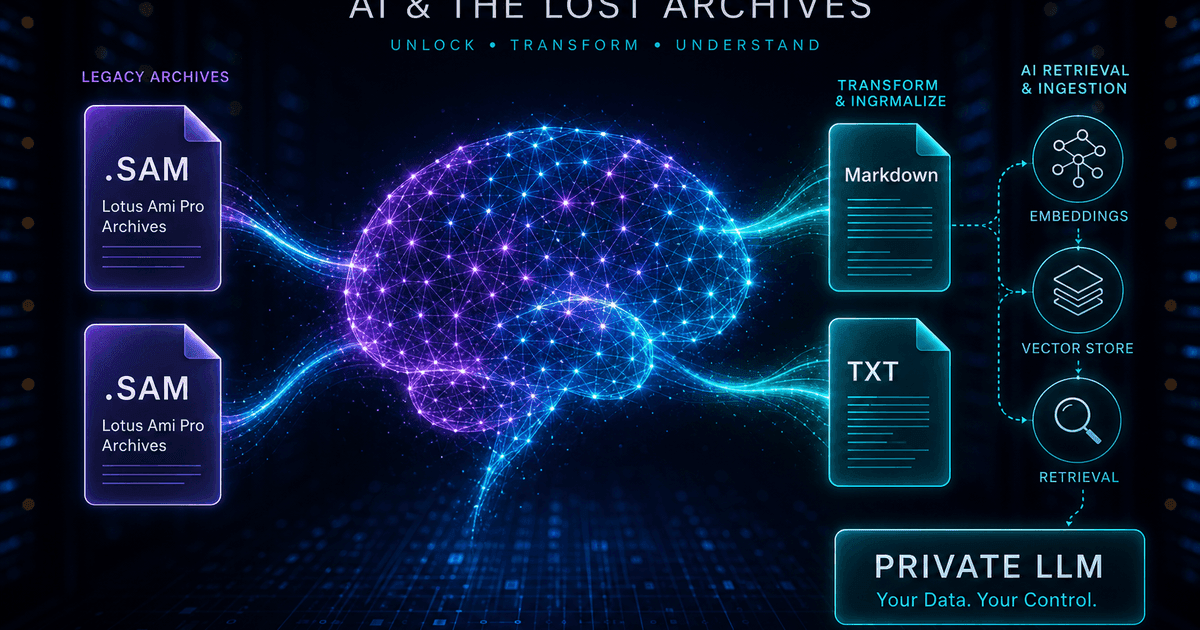
TL;DR
Para un modelo de lenguaje, tu archivo Ami Pro no existe. Conviértelo a Markdown en lugar de PDF: los encabezados se conservan como estructura sobre la que un segmentador puede dividir, las tablas permanecen legibles, las ecuaciones llegan como LaTeX, y evitas el ruido de extracción que introducen las canalizaciones de PDF. Segmenta por encabezado, adjunta metadatos para filtrado, inserta localmente y mantén toda la canalización fuera de línea: la misma confidencialidad que hace que valga la pena construir un sistema RAG privado se aplica al paso de conversión. Comienza con Ami Pro Converter.
El problema del corpus invisible
Las organizaciones que construyen asistentes de IA internos suelen descubrir la misma brecha. El sistema responde preguntas sobre cualquier cosa escrita en los últimos quince años y se queda en blanco con todo lo más antiguo, porque el material más antiguo está en formatos que ninguna canalización de ingestión puede leer. Para las instituciones que estaban usando Ami Pro a principios de la década de 1990, eso puede significar que todo el período fundacional de una política, producto o posición legal está perdido.
La consecuencia es más sutil que un índice incompleto. Un sistema de recuperación que carece silenciosamente de contexto histórico no dice "No tengo eso"; responde con lo que tiene, con confianza, y la respuesta omite el razonamiento que ha formado todo desde entonces. Nadie lo nota, porque la brecha es invisible desde el exterior.
Por lo tanto, convertir el archivo heredado no es un ejercicio de ordenamiento. Es la diferencia entre un asistente que sabe por qué se tomaron decisiones y uno que solo conoce el estado actual.
Por qué Markdown, no PDF
El instinto es convertir todo a PDF porque PDF es el valor predeterminado de archivo, y luego ejecutar la extracción de PDF en la cadena de procesamiento. Esta es la herida autoinfligida más común en proyectos RAG sobre contenido heredado, porque conviertes la estructura en diseño y luego pagas por adivinar la estructura de nuevo.
La extracción PDF reintroduce todos los artefactos del diseño como ruido: confusión en el orden de las columnas, encabezados y pies de página apareciendo a mitad de párrafo, cortes de línea con guion que dividen palabras, y tablas que colapsan en flujos de números sin asociación de filas o columnas. Luego, el modelo razona sobre ese desorden.
Markdown va en la otra dirección. Debido a que los documentos Ami Pro contienen información de estilo explícita en sus hojas .STY, los encabezados pueden emitirse como encabezados reales de Markdown, las listas como listas y las tablas como tablas de tuberías. Tu segmentador obtiene una estructura genuina, tus incrustaciones consiguen texto limpio y no gastas nada en heurísticas de extracción.
Un conducto que funciona
1. Inventariar el archivo
Encuentra todos los archivos .sam incluyendo las variantes en mayúsculas .SAM, confirma que las hojas de estilo .STY estén presentes y registra el conteo. Sin las hojas de estilo, tu Markdown pierde la estructura de encabezados, que es lo único que estás convirtiendo.
2. Convertir a Markdown, y TXT para triaje
Emite ambos en una sola pasada. Markdown alimenta el índice; el texto plano te da una forma rápida de buscar en el corpus, detectar duplicados cercanos e identificar documentos vacíos o de plantilla antes de gastar presupuesto de incrustación en ellos.
3. Dividir por encabezado, no por número de caracteres
La segmentación de tamaño fijo corta en el medio de los argumentos. Divide en límites de encabezado con una superposición modesta para que cada segmento sea una unidad coherente, y lleva la ruta del encabezado al texto del segmento para que la recuperación sepa de dónde proviene.
4. Adjuntar metadatos para filtrar
Etiqueta cada fragmento con el nombre del archivo de origen, la fecha del documento, el departamento y la ruta de la carpeta. Los corpus históricos hacen que el filtrado de metadatos sea esencial: "qué decía la política de 1996" es un filtro más una búsqueda, no solo una búsqueda.
5. Incrustar e indexar localmente
Ejecuta un modelo de incrustación local y almacena vectores en pgvector, Chroma, Qdrant o similar. Si la confidencialidad es la razón por la que estás construyendo un sistema privado, enviar el corpus a una API de incrustación alojada anula el principio.
Qué hace que los documentos heredados sean especiales para indexar
Los documentos antiguos están llenos de referencias a cosas que ya no existen: nombres de departamentos reemplazados, códigos de productos descontinuados, títulos de trabajo anteriores, números de regulaciones obsoletas. Un modelo no puede resolverlos por sí mismo, y un usuario que haga una pregunta moderna no utilizará el vocabulario histórico.
La mitigación económica es un pequeño glosario insertado en el aviso del sistema, que mapea los nombres antiguos a los actuales. Casi no cuesta nada y mejora drásticamente la recuperación en un corpus histórico.
La otra característica es que los documentos antiguos a menudo son reemplazados pero no se marcan como tales. Un procedimiento de 1994 y su reemplazo de 2003 parecen igualmente autorizativos para un sistema de recuperación. Los metadatos de fecha, junto con una instrucción explícita de preferir las fuentes recientes y de indicar la fecha de cualquier respuesta histórica, previenen el modo de fallo más dañino: citar una política derogada como si fuera actual.
Tablas y ecuaciones en un flujo de trabajo de IA
Las tablas son donde la elección del formato más se nota visiblemente. Una tabla de tubos Markdown mantiene la asociación entre un valor, su encabezado de columna y su etiqueta de fila, por lo que un modelo puede responder preguntas sobre una celda específica. La misma tabla extraída de un PDF es frecuentemente una secuencia de números con los encabezados separados, y un modelo al que se le pide interpretarla adivinará.
Las ecuaciones se comportan de manera similar. Recuperadas como imágenes renderizadas, son invisibles para la búsqueda de texto y para el modelo; recuperadas como LaTeX, son buscables, embebibles y volvibles a renderizar. Para archivos técnicos —cálculos de ingeniería, artículos académicos, notas actuariales— la extracción en LaTeX es lo que hace que el corpus sea genuinamente consultable y no solo presente.
Cuando un documento es fundamentalmente visual, acéptalo. Conviértelo a PDF para la lectura humana, indexa cualquier texto que contenga, y registra en los metadatos que la sustancia es gráfica para que la recuperación pueda dirigir a una persona al original en lugar de pretender resumirlo.
Mantén toda la tubería fuera de línea
La mayoría de los proyectos privados de RAG existen precisamente porque el material no puede ir a un tercero. Vale la pena notar cuando el paso de conversión rompe silenciosamente esa regla: usar un convertidor basado en la web para preparar documentos para un sistema cuyo propósito entero es la confidencialidad es una contradicción que tiende a sobrevivir porque la conversión se trata como fontanería en lugar de como procesamiento.
Un convertidor de escritorio local mantiene la cadena de custodia intacta desde el archivo .sam hasta el almacén vectorial. No se transmite nada, por lo que no hay transferencia que evaluar o documentar, y el flujo de trabajo puede ejecutarse en una estación de trabajo aislada si eso es lo que requiere el material.
Combina eso con un modelo de incrustación local y una base de datos vectorial autoalojada, y tendrás un sistema que puedes describir honestamente en una revisión de cumplimiento: el corpus nunca salió de la red en ninguna etapa.
Por qué Markdown primero supera a PDF primero en RAG
- Los encabezados sobreviven como estructura, así la fragmentación sigue la lógica del propio documento
- Las tablas mantienen la relación entre encabezado y valor que la extracción de PDF destruye
- Las ecuaciones llegan como LaTeX: buscables y legibles por máquina, no imágenes
- Sin fase de OCR ni de reconstrucción del diseño, así hay menos tokens y menos ruido
- Todo el proceso sigue sin conexión, preservando la confidencialidad que lo justificaba
Décadas de contexto, finalmente consultable
Los documentos más valiosos en una organización suelen ser los más antiguos, porque registran por qué las cosas son como son. Dejarlo en un formato que nadie pueda leer significa que tu sistema de IA conoce el presente y nada del razonamiento detrás de ello.
Convierte el archivo a Markdown con las hojas de estilo aplicadas, dividelo por encabezados, etiquétalo con fechas y departamentos, incrústalo localmente, y dile al modelo que sea explícito sobre qué tan antiguas son tus fuentes. El corpus pasa de ser invisible a buscable, y nunca abandona tu red.
Convierte tus archivos
Lecturas relacionadas
Haz que tu archivo Ami Pro sea legible por IA
La prueba gratuita convierte hasta 10 .sam archivos a Markdown con extracción de ecuaciones LaTeX — prueba tu fragmentación antes de comprometerte con todo el corpus.
Prueba gratuita
Funciones completas de la aplicación — hasta 10 archivos
Windows 10 o 11
Descarga el Instalador de Windows para la prueba completa de 10 archivos. La misma aplicación que desbloquea con una licencia — 100 % local en tu PC.