Preparazione degli Archivi Ami Pro per la Ricerca AI e RAG
Decenni di conoscenza istituzionale sono contenuti in un formato che nessun modello può leggere. Ecco la pipeline che cambia questo — e perché il passaggio di conversione decide quanto sarà buona l'intero sistema.
TL;DR
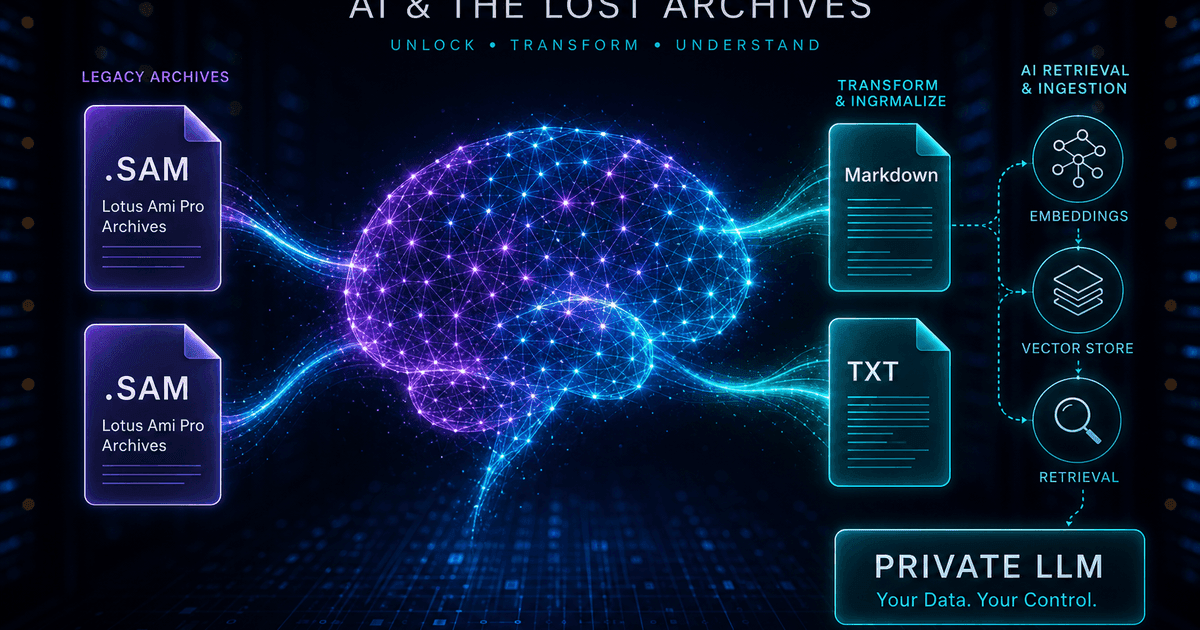
Per un modello di linguaggio, il tuo archivio Ami Pro non esiste. Convertirlo in Markdown piuttosto che in PDF: i titoli rimangono come struttura su cui un segmentatore può suddividere, le tabelle restano leggibili, le equazioni arrivano come LaTeX, ed eviti il rumore di estrazione introdotto dalle pipeline PDF. Segmenta per titolo, allega metadati per il filtraggio, incorpora localmente e mantieni l'intera pipeline offline — la stessa riservatezza che rende utile costruire un sistema RAG privato si applica anche al passaggio di conversione. Inizia con Ami Pro Converter.
Il problema del corpus invisibile
Le organizzazioni che costruiscono assistenti AI interni di solito scoprono lo stesso divario. Il sistema risponde a domande su qualsiasi cosa scritta negli ultimi quindici anni e rimane vuoto su tutto ciò che è più vecchio, perché il materiale più antico è in formati che nessuna pipeline di ingestione può leggere. Per le istituzioni che utilizzavano Ami Pro all'inizio degli anni '90, questo può significare che l'intero periodo di fondazione di una politica, prodotto o posizione legale è mancante.
La conseguenza è più sottile di un indice incompleto. Un sistema di recupero che manca silenziosamente del contesto storico non dice "Non ho questo"; risponde con ciò che ha, con sicurezza, e la risposta omette il ragionamento che ha plasmato tutto da allora. Nessuno se ne accorge, perché il divario è invisibile dall'esterno.
Convertire l'archivio legacy quindi non è un esercizio di riordino. È la differenza tra un assistente che sa perché sono state prese delle decisioni e uno che conosce solo lo stato attuale.
Perché Markdown, non PDF
L'istinto è di convertire tutto in PDF perché PDF è il default per l'archiviazione, e poi eseguire l'estrazione PDF nella pipeline. Questa è la ferita autoinflitta più comune nei progetti RAG sui contenuti legacy, perché converti la struttura in layout e poi paghi per indovinare di nuovo la struttura.
L'estrazione PDF reintroduce ogni artificio del layout come rumore: confusione nell'ordine delle colonne, intestazioni e piè di pagina che appaiono a metà paragrafo, interruzioni di linea con trattino che dividono le parole e tabelle che collassano in flussi di numeri senza alcuna associazione tra righe e colonne. Il modello poi ragiona su quel caos.
Markdown va nell'altra direzione. Poiché i documenti Ami Pro contengono informazioni di stile esplicite nei loro fogli .STY, le intestazioni possono essere emesse come vere intestazioni Markdown, le liste come liste e le tabelle come tabelle a pipe. Il tuo chunker ottiene una struttura genuina, i tuoi embedding ottengono testo pulito e non spendi nulla per le euristiche di estrazione.
Una pipeline che funziona
1. Inventariare l'archivio
Trova ogni file .sam inclusi i varianti maiuscole .SAM, conferma che i fogli di stile .STY siano presenti e registra il conteggio. Senza fogli di stile il tuo Markdown perde la struttura delle intestazioni, che è l'unica cosa che stai convertendo.
2. Convertire in Markdown, e TXT per triage
Emetti entrambi in un solo passaggio. Markdown fornisce l'indice; il testo semplice ti offre un modo rapido per cercare nel corpus, individuare quasi-duplicati e identificare documenti vuoti o modello prima di spendere il budget per l'embedding su di essi.
3. Dividi per intestazione, non per numero di caratteri
La suddivisione a dimensione fissa taglia attraverso il mezzo degli argomenti. Dividi sui confini delle intestazioni con una sovrapposizione modesta in modo che ogni pezzo sia un'unità coerente e porta il percorso dell'intestazione nel testo del pezzo così che il recupero sappia da dove proviene.
4. Allega i metadati per il filtraggio
Etichetta ogni blocco con il nome del file sorgente, la data del documento, il dipartimento e il percorso della cartella. I corpora storici rendono essenziale il filtraggio dei metadati — "cosa diceva la politica del 1996" è un filtro più una ricerca, non solo una ricerca.
5. Incorpora e indicizza localmente
Esegui un modello di embedding locale e memorizza i vettori in pgvector, Chroma, Qdrant o simili. Se la riservatezza è il motivo per cui stai costruendo un sistema privato, inviare il corpus a un'API di embedding ospitata vanifica il presupposto.
Cosa rende speciali i documenti legacy da indicizzare
I vecchi documenti sono densi di riferimenti a cose che non esistono più: nomi di dipartimenti sostituiti, codici di prodotto dismessi, vecchi titoli di lavoro, numeri di regolamento obsoleti. Un modello non può risolverli da solo, e un utente che fa una domanda moderna non utilizzerà il vocabolario storico.
La mitigazione economica è un piccolo glossario inserito nel prompt del sistema, che mappa i vecchi nomi a quelli attuali. Costa quasi nulla e migliora drasticamente il richiamo su un corpus storico.
L'altra caratteristica è che i documenti legacy vengono spesso superati ma non contrassegnati come tali. Una procedura del 1994 e la sua sostituzione del 2003 appaiono ugualmente autorevoli a un sistema di recupero. I metadati sulla data, insieme a un'istruzione esplicita di preferire fonti recenti e di indicare la data di qualsiasi risposta storica, prevengono la modalità di errore più dannosa: citare una politica abrogata come se fosse attuale.
Tabelle ed equazioni in una pipeline di intelligenza artificiale
Le tabelle sono il luogo in cui la scelta del formato dà i risultati più visibili. Una tabella a tubi Markdown mantiene l'associazione tra un valore, l'intestazione della colonna e l'etichetta della riga, quindi un modello può rispondere a domande su una cella specifica. La stessa tabella estratta da un PDF è frequentemente una sequenza di numeri con le intestazioni staccate — e un modello a cui viene chiesto di interpretarla indovinerà.
Le equazioni si comportano in modo simile. Recuperate come immagini rese, sono invisibili alla ricerca testuale e al modello; recuperate come LaTeX, sono ricercabili, incorporabili e ri-renderizzabili. Per archivi tecnici — calcoli ingegneristici, articoli accademici, note attuariali — l'estrazione in LaTeX è ciò che rende il corpus genuinamente interrogabile piuttosto che semplicemente presente.
Quando un documento è fondamentalmente visivo, accettalo. Convertilo in PDF per la lettura umana, indicizza qualsiasi testo contenga e registra nei metadati che il contenuto è grafico in modo che il recupero possa indirizzare una persona all'originale invece di fingere di riassumerlo.
Tieni l'intera pipeline offline
La maggior parte dei progetti RAG privati esistono precisamente perché il materiale non può essere condiviso con terzi. Vale la pena notare quando il passaggio di conversione infrange silenziosamente quella regola: usare un convertitore basato sul web per preparare documenti per un sistema il cui scopo principale è la riservatezza è una contraddizione che tende a persistere perché la conversione viene trattata come impiantistica piuttosto che come elaborazione.
Un convertitore desktop locale mantiene intatta la catena di custodia dal file .sam allo store vettoriale. Non viene trasmesso nulla, quindi non c'è alcun trasferimento da valutare o documentare, e la pipeline può funzionare su una postazione isolata se è ciò che il materiale richiede.
Abbinalo a un modello di embedding locale e a un database vettoriale auto-ospitato e avrai un sistema che puoi descrivere onestamente in una revisione di conformità: il corpus non ha mai lasciato la rete in nessuna fase.
Perché partire dal Markdown batte partire dal PDF per il RAG
- I titoli sopravvivono come struttura, così la suddivisione in blocchi segue la logica del documento
- Le tabelle mantengono il legame tra intestazione e valore che l’estrazione da PDF distrugge
- Le equazioni arrivano in LaTeX: ricercabili e leggibili dalle macchine, non immagini
- Nessuna fase di OCR o di ricostruzione del layout, quindi meno token e meno rumore
- L’intera pipeline resta offline, preservando la riservatezza che la giustificava
Decenni di contesto, finalmente interrogabili
I documenti più preziosi in un'organizzazione sono spesso i più vecchi, perché registrano il motivo per cui le cose sono come sono. Lasciarli in un formato che nessuno può leggere significa che il tuo sistema di intelligenza artificiale conosce il presente e nulla del ragionamento che lo ha portato.
Converti l'archivio in Markdown con i fogli di stile applicati, suddiviso per intestazione, etichettato con date e dipartimenti, incorporato localmente, e indica al modello di essere esplicito sull'età delle sue fonti. Il corpus diventa da invisibile a ricercabile e non lascia mai la tua rete.
Converti i tuoi file
Letture correlate
Rendi il tuo archivio Ami Pro leggibile dall'IA
La prova gratuita converte fino a 10 .sam file in Markdown con estrazione delle equazioni LaTeX — testa la tua suddivisione in parti prima di impegnarti con l'intero corpus.
Prova gratuita
Tutte le funzionalità dell'app — fino a 10 file
Windows 10 o 11
Scarica l'Installatore Windows per la prova completa di 10 file. La stessa app che sblocchi con una licenza — 100 % locale sul tuo PC.