AIおよびRAG検索のためのAmi Proアーカイブの準備
何十年もの組織的知識が、どのモデルも読み取れない形式で存在しています。こちらはそれを変えるパイプラインです — そして、変換ステップがシステム全体の良し悪しを決める理由も解説します。
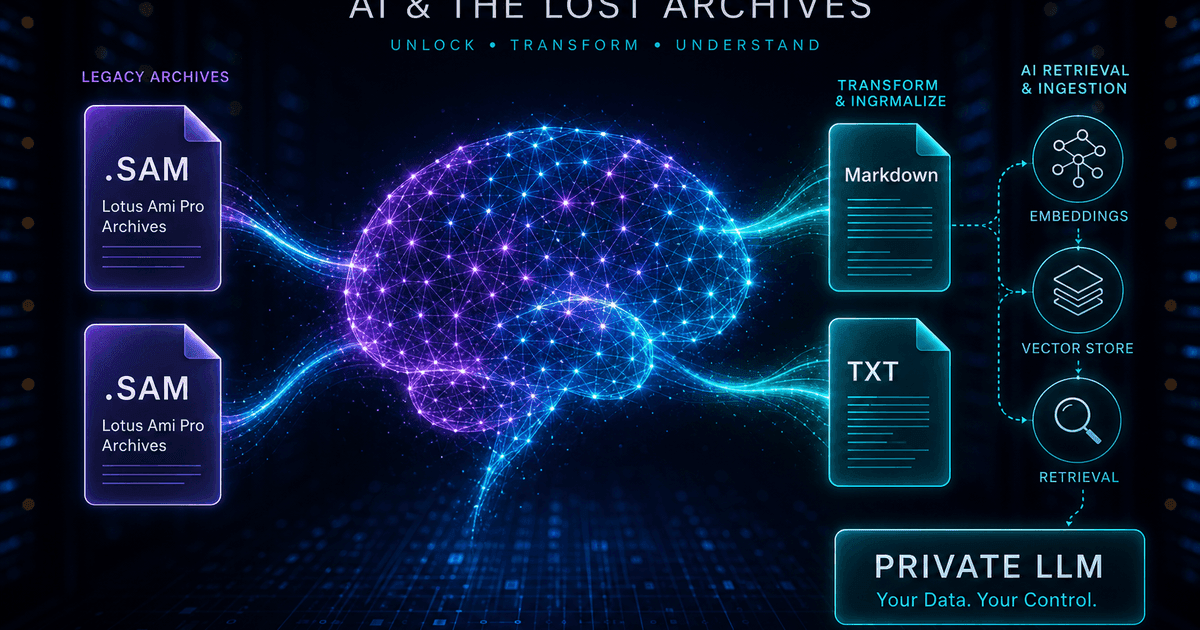
TL;DR
言語モデルにとって、あなたのAmi Proアーカイブは存在しません。PDFではなくMarkdownに変換してください:見出しはチャンク分け可能な構造として保持され、表は読みやすく、式はLaTeXとして到達し、PDFパイプラインが導入する抽出ノイズを避けられます。見出しごとにチャンク分けし、フィルタリング用のメタデータを添付し、ローカルに埋め込み、パイプライン全体をオフラインで維持してください — プライベートRAGシステムを構築する価値があるのと同じ機密性が、変換ステップにも適用されます。まずAmi Pro Converterから始めてください。
目に見えないコーパスの問題
内部AIアシスタントを構築している組織は、通常同じギャップに気づきます。そのシステムは過去15年間に書かれたあらゆることについて質問に答えますが、それ以前のものについては応答できません。なぜなら、以前の資料はどの取り込みパイプラインも読み取れない形式になっているからです。1990年代初頭にAmi Proを使用していた機関にとっては、政策、製品、または法的立場の創設期全体が欠落していることを意味する場合があります。
その結果は、不完全な索引よりも微妙です。歴史的な文脈を密かに欠いた検索システムは「それは持っていません」とは言いません;それは持っているものから自信を持って答え、その答えはそれ以降のすべてを形作った推論を省略します。誰も気づきません、なぜならそのギャップは外側からは見えないからです。
したがって、レガシーアーカイブの変換は単なる整理作業ではありません。それは、なぜ決定が行われたのかを知っているアシスタントと、現在の状態しか知らないアシスタントの違いです。
なぜPDFではなくMarkdownなのですか
本能的には、すべてをPDFに変換することです。なぜならPDFがアーカイブのデフォルトだからで、その後パイプラインでPDF抽出を実行します。これは、レガシーコンテンツに関するRAGプロジェクトで最も一般的な自己造成的な問題です。なぜなら、構造をレイアウトに変換し、それから構造を推測するために費用を払うことになるからです。
PDFの抽出は、あらゆるレイアウトの人工物をノイズとして再導入します:列の順序の混乱、段落の途中に現れるヘッダーやフッター、単語を分割するハイフン付きの改行、行や列の関連がなく数字の流れに崩れた表などです。その後、モデルはその混乱の上で推論します。
Markdown は逆の方法です。Ami Pro のドキュメントには .STY シートに明示的なスタイル情報が含まれているため、見出しは実際の Markdown 見出しとして出力でき、リストはリストとして、表はパイプ表として出力できます。チャンカーは本物の構造を取得し、埋め込みはきれいなテキストを取得し、抽出ヒューリスティックに費用をかける必要はありません。
動作するパイプライン
1. アーカイブを在庫確認する
大文字の.SAMバリエーションを含むすべての.samファイルを見つけ、.STYスタイルシートが存在することを確認し、数を記録してください。スタイルシートがなければ、Markdownは見出し構造を失います。これは、変換しようとしている唯一のものであるためです。
2. Markdown に変換し、トリアージ用に TXT にする
両方を一度に出力します。Markdown がインデックスに供給します。プレーンテキストを使うと、コーパスを素早くgrepしたり、類似文書を見つけたり、埋め込み予算を使う前に空の文書やテンプレート文書を特定する簡単な方法が得られます。
3. 文字数ではなく見出しごとに分ける
固定サイズの分割は議論の中央を貫通します。各チャンクが一貫した単位になるように、適度な重なりを持たせて見出しの境界で分割し、見出しのパスをチャンクのテキストに引き継ぐことで、取得時にどこから来たかが分かるようにします。
4. フィルタリング用のメタデータを添付する
すべてのチャンクに、元のファイル名、文書の日付、部署、フォルダパスをタグ付けしてください。過去のコーパスでは、メタデータによるフィルタリングが不可欠です — 「1996年の方針では何が述べられていましたか」は、検索だけでなくフィルタリングも含まれるものです。
5. ローカルに埋め込み、インデックス化する
ローカルの埋め込みモデルを実行し、ベクトルを pgvector、Chroma、Qdrant、または同様のものに保存します。機密性が理由でプライベートシステムを構築している場合、コーパスをホストされている埋め込み API に送信することは、その前提を無効にします。
レガシー文書をインデックス化する際に特別なものは何ですか
古い文書には、もはや存在しないものへの参照が密集しています:廃止された部門名、製造中止になった製品コード、以前の職位、廃止された規制番号などです。モデルはそれらを自力で解決することはできず、現代的な質問をするユーザーは歴史的な語彙を使用しません。
安価な緩和策は、システムプロンプトに挿入された小さな用語集で、古い名前を現在の名前にマッピングするものです。ほとんど費用がかからず、歴史的なコーパスでのリコールを劇的に改善します。
もう一つの特徴は、従来の文書がしばしば廃止されてもそのように表示されないことです。1994年の手続きと2003年の後継手続きは、検索システムには同等の権威があるように見えます。日付のメタデータに加え、最近の情報源を優先し、歴史的な回答には日付を明記するよう明確に指示することで、最も重大な失敗モード、すなわち廃止された方針を現在のものとして引用してしまうことを防ぎます。
AIパイプラインの表と方程式
テーブルは、フォーマットの選択が最も目に見える形で効果を発揮する場所です。Markdown パイプテーブルは、値、その列ヘッダー、および行ラベルとの関連を保持するため、モデルは特定のセルに関する質問に答えることができます。同じテーブルがPDF から抽出されると、ヘッダーが切り離された数字のシーケンスになることが多く、解釈するように求められたモデルは推測します。
方程式も同様に振る舞います。レンダリングされた画像として復元されると、テキスト検索やモデルには見えません;LaTeXとして復元されると、検索可能で、埋め込み可能で、再レンダリング可能です。技術アーカイブ―工学計算、学術論文、保険数理ノートにおいて―LaTeX抽出こそが、コーパスを単に存在するだけでなく、本当に問い合わせ可能にするものです。
文書が基本的に視覚的なものである場合は、それを受け入れなさい。PDF に変換して人間が読めるようにし、含まれているテキストをインデックス化し、内容が図表であることをメタデータに記録して、検索時に人に要約を装うのではなく元の文書を指し示せるようにしなさい。
パイプライン全体をオフラインに保つ
ほとんどのプライベートなRAGプロジェクトは、まさにその資料が第三者に渡せないために存在しています。変換の段階で密かにそのルールが破られるときに注目する価値があります。すなわち、ウェブベースのコンバーターを使って、機密保持を目的としたシステム向けに文書を準備することは、矛盾であり、それが生き続ける傾向があります。なぜなら、変換が処理ではなく配管作業として扱われるからです。
ローカルのデスクトップコンバーターは、.samファイルからベクターストアへの管理の連鎖を維持します。何も送信されないため、評価や記録する必要のある転送はなく、素材が要求する場合には、そのパイプラインを隔離されたワークステーションで実行することができます。
それをローカルの埋め込みモデルと自分でホストするベクトルデータベースと組み合わせれば、コンプライアンスレビューで正直に説明できるシステムが手に入ります:コーパスはどの段階でもネットワークを離れることはありませんでした。
RAG では PDF より Markdown を起点にすべき理由
- 見出しが構造として残るため、チャンク分割が文書本来の論理に沿います
- PDF 抽出では失われる、表の見出しと値の対応関係を保持
- 数式は画像ではなく、検索可能で機械可読な LaTeX として取り込まれます
- OCR やレイアウト再構成の工程がないため、トークンもノイズも少なくなります
- パイプライン全体がオフラインのまま動くので、そもそもの理由である機密性を守れます
何十年もの文脈が、ついに検索可能に
組織で最も価値のある文書は、しばしば最も古いものです。なぜなら、それらは物事が現在の状態になった理由を記録しているからです。それらを誰も読めない形式のままにしておくと、あなたのAIシステムは現在のことは知っていても、その背後にある理由を全く理解できないことになります。
アーカイブをスタイルシートを適用した状態でMarkdownに変換し、見出しごとに分割し、日付と部門のタグを付け、ローカルに埋め込み、モデルにソースの古さを明確に示すよう指示します。コーパスは見えない状態から検索可能な状態になり、ネットワーク外に出ることはありません。
関連記事
あなたのAmi ProアーカイブをAIが読み取れるようにする
無料トライアルでは、最大 10 .sam ファイルを Markdown に LaTeX 式の抽出付きで変換できます — 全コーパスに取り組む前にチャンク処理をテストしてください。
無料トライアル
アプリの全機能 — 最大 10 ファイル
Windows 10 または 11
完全な 10 ファイルのトライアルには Windows インストーラー をダウンロードしてください。ライセンスでアンロックするのは同じアプリ — PC上で100%ローカル処理。