Förbereder Ami Pro-arkiv för AI och RAG-sökning
Decennier av institutionell kunskap finns i ett format som inget system kan läsa. Här är processen som ändrar det — och varför konverteringssteget avgör hur bra hela systemet kommer att bli.
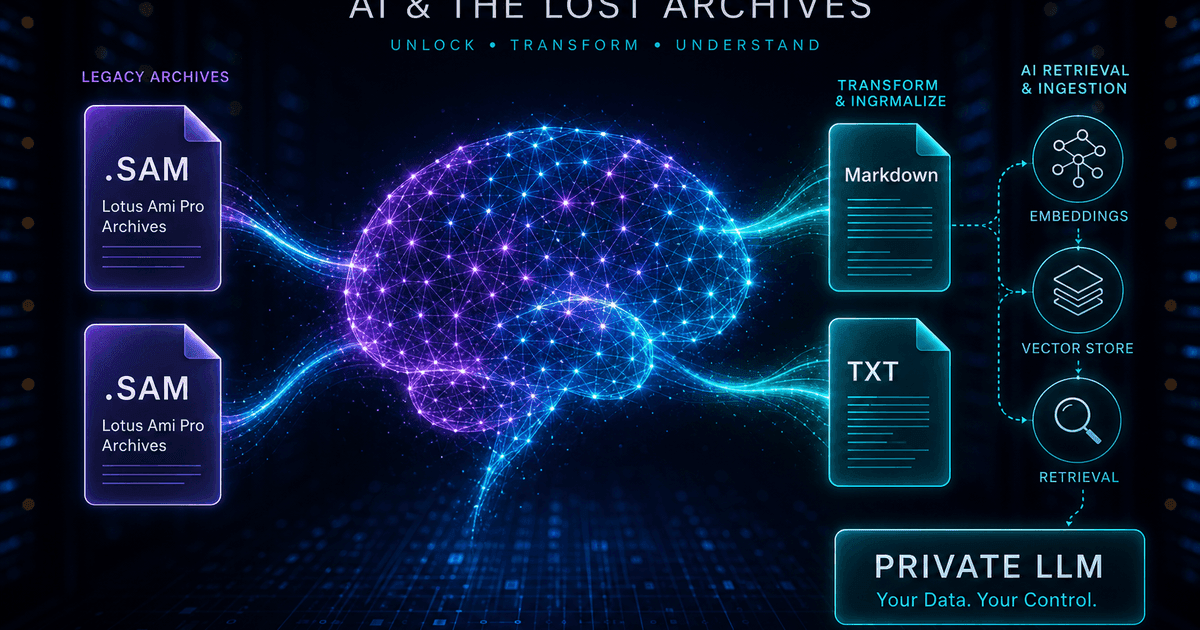
TL;DR
För ett språkmodell finns ditt Ami Pro-arkiv inte. Konvertera det till Markdown istället för PDF: rubriker bevaras som struktur som en chunker kan dela på, tabeller förblir läsbara, ekvationer kommer som LaTeX, och du undviker det extraktionsbrus som PDF-pipeline introducerar. Dela upp efter rubrik, lägg till metadata för filtrering, bädda in lokalt, och håll hela processen offline — samma sekretess som gör ett privat RAG-system värt att bygga gäller för konverteringssteget. Börja med Ami Pro Converter.
Problemet med det osynliga korpuset
Organisationer som bygger interna AI-assistenter upptäcker vanligtvis samma lucka. Systemet svarar på frågor om allt som är skrivet de senaste femton åren och står helt stilla när det gäller äldre material, eftersom det äldre materialet finns i format som ingen insamlingspipeline kan läsa. För institutioner som använde Ami Pro i början av 1990-talet kan det innebära att hela grundläggande perioden för en policy, produkt eller rättslig ståndpunkt saknas.
Konsekvensen är mer subtil än ett ofullständigt index. Ett återvinningssystem som tyst saknar historiskt sammanhang säger inte "Jag har inte det"; det svarar utifrån det det har, med förtroende, och svaret utelämnar den resonemang som har format allt sedan dess. Ingen märker det, eftersom gapet är osynligt från utsidan.
Att omvandla det gamla arkivet är därför inte en städinsats. Det är skillnaden mellan en assistent som vet varför beslut fattades och en som bara vet det nuvarande tillståndet.
Varför Markdown, inte PDF
Instinkten är att konvertera allt till PDF eftersom PDF är arkivstandarden, och sedan köra PDF-extraktion i pipelinen. Detta är det vanligaste självförvållade misstaget i RAG-projekt över legacyinnehåll, eftersom du konverterar struktur till layout och sedan betalar för att gissa tillbaka strukturen.
PDF-extraktion återinför varje layoutartefakt som brus: förvirring i kolumnordning, löpande rubriker och sidfötter som dyker upp mitt i ett stycke, ord som delas av bindestreck vid radbrytningar och tabeller som kollapsar till strömmar av siffror utan rad- eller kolumnassociation. Modellen resonerar sedan över det kaoset.
Markdown går åt andra hållet. Eftersom Ami Pro-dokument innehåller explicit stilinformation i sina .STY-blad, kan rubriker genereras som riktiga Markdown-rubriker, listor som listor och tabeller som pipetabeller. Din chunker får äkta struktur, dina inbäddningar får ren text, och du spenderar ingenting på extraktionsheuristik.
En pipeline som fungerar
1. Inventera arkivet
Hitta varje .sam-fil inklusive stora .SAM-varianter, bekräfta att .STY-stilmallarna finns, och registrera antalet. Utan stilmallar förlorar din Markdown rubrikstruktur, vilket är det enda du konverterar för.
2. Konvertera till Markdown och TXT för triage
Emittera båda på en pass. Markdown matar indexet; vanlig text ger dig ett snabbt sätt att söka i korpusen, upptäcka nästan-duplikat och identifiera tomma eller mallade dokument innan du spenderar inbäddningsbudget på dem.
3. Dela upp efter rubrik, inte efter antal tecken
Chunking med fast storlek skär genom mitten av argument. Dela vid rubrikgränser med en måttlig överlappning så att varje chunk blir en sammanhängande enhet, och för med rubrikvägen in i chunk-texten så att återhämtning vet var den kom från.
4. Bifoga metadata för filtrering
Tagga varje del med källfilens namn, dokumentdatum, avdelning och mappväg. Historiska korpusar gör metadatafiltrering nödvändig — "vad sade policyn från 1996" är ett filter plus en sökning, inte enbart en sökning.
5. Bädda in och indexera lokalt
Kör en lokal inbäddningsmodell och lagra vektorer i pgvector, Chroma, Qdrant eller liknande. Om sekretess är anledningen till att du bygger ett privat system, upphäver det att skicka korpusen till en värdbaserad inbäddnings-API premissen.
Vad som gör äldre dokument speciella att indexera
Gamla dokument är fyllda med referenser till saker som inte längre existerar: åldrade avdelningsnamn, avvecklade produktkoder, tidigare jobbtitlar, föråldrade föreskriftsnummer. En modell kan inte lösa dessa på egen hand, och en användare som ställer en modern fråga kommer inte att använda det historiska vokabuläret.
Den billiga åtgärden är en liten ordlista som injiceras i systemuppmaningen, och som kopplar gamla namn till nuvarande. Den kostar nästan ingenting och förbättrar dramatiskt återkallelsen på ett historiskt korpus.
Den andra egenskapen är att gamla dokument ofta ersätts men inte markeras som sådana. Ett förfarande från 1994 och dess ersättning från 2003 ser lika auktoritativa ut för ett återvinningssystem. Datummetadata plus en uttrycklig instruktion att föredra nyare källor och att ange datum för varje historiskt svar förhindrar det mest skadliga felläget: att citera en upphävd policy som aktuell.
Tabeller och ekvationer i en AI-pipeline
Tabeller är där formatval ger mest synlig utdelning. En Markdown-rörledningstabell behåller kopplingen mellan ett värde, dess kolumnrubrik och dess radetikett, så en modell kan svara på frågor om en specifik cell. Samma tabell extraherad från en PDF är ofta en sekvens av siffror med rubrikerna separerade — och en modell som ombeds tolka den kommer att gissa.
Ekvationer beter sig på samma sätt. Återställda som återgivna bilder är de osynliga för text-sökning och för modellen; återställda som LaTeX är de sökbara, inbäddningsbara och om-renderbara. För tekniska arkiv — ingenjörsberäkningar, akademiska artiklar, aktuarienoteringar — är LaTeX-extraktion det som gör korpusen verkligen sökbar snarare än bara närvarande.
När ett dokument är grundläggande visuellt, acceptera det. Konvertera det till PDF för mänsklig läsning, indexera den text det innehåller och registrera i metadata att innehållet är grafiskt så att återvinning kan peka en person till originalet istället för att låtsas sammanfatta det.
Håll hela processen offline
De flesta privata RAG-projekt finns just därför att materialet inte kan gå till en tredje part. Det är värt att notera när omvandlingssteget tyst bryter mot den regeln: att använda en webbaserad omvandlare för att förbereda dokument för ett system vars hela syfte är sekretess är en motsägelse som tenderar att överleva eftersom omvandlingen behandlas som rördragning snarare än som bearbetning.
En lokal skrivbordsomvandlare håller kedjan av försörjning intakt från .sam-fil till vektorlager. Ingenting överförs, så det finns ingen överföring att bedöma eller dokumentera, och pipelinen kan köras på en isolerad arbetsstation om det är vad materialet kräver.
Kombinera det med en lokal inbäddningsmodell och en självhostad vektordatabas så har du ett system som du kan beskriva ärligt i en efterlevnadsgranskning: korpusen lämnade aldrig nätverket vid något tillfälle.
Därför slår Markdown först PDF först för RAG
- Rubriker bevaras som struktur, så uppdelningen följer dokumentets egen logik
- Tabeller behåller kopplingen mellan rubrik och värde som PDF-extrahering förstör
- Ekvationer kommer som LaTeX – sökbara och maskinläsbara, inte bilder
- Inget OCR- eller layoutåterskapningssteg, så färre tokens och mindre brus
- Hela kedjan förblir offline och bevarar den konfidentialitet som motiverade den
Decennier av sammanhang, äntligen frågbar
De mest värdefulla dokumenten i en organisation är ofta de äldsta, eftersom de registrerar varför saker är som de är. Att lämna dem i ett format som ingen kan läsa innebär att ditt AI-system vet nuet men inget av resonemanget bakom det.
Konvertera arkivet till Markdown med tillämpade stilmallar, dela upp efter rubrik, tagga med datum och avdelningar, bädda in lokalt, och instruera modellen att vara tydlig med hur gamla dess källor är. Korpuset går från osynligt till sökbart, och det lämnar aldrig ditt nätverk.
Konvertera dina filer
Relaterad läsning
Gör ditt Ami Pro-arkiv AI-läsbart
Gratis provperiod konverterar upp till 10 .sam filer till Markdown med LaTeX-ekvationsutdrag — testa din uppdelning innan du går vidare med hela korpusen.
Gratis provperiod
Alla appfunktioner — upp till 10 filer
Windows 10 eller 11
Ladda ner Windows-installationsprogram för den fullständiga 10-filers provperioden. Samma app som du låser upp med en licens — 100 % lokalt på din PC.