Préparer les archives Ami Pro pour la recherche IA et RAG
Des décennies de connaissances institutionnelles sont stockées dans un format qu'aucun modèle ne peut lire. Voici le pipeline qui change cela — et pourquoi l'étape de conversion détermine la qualité de l'ensemble du système.
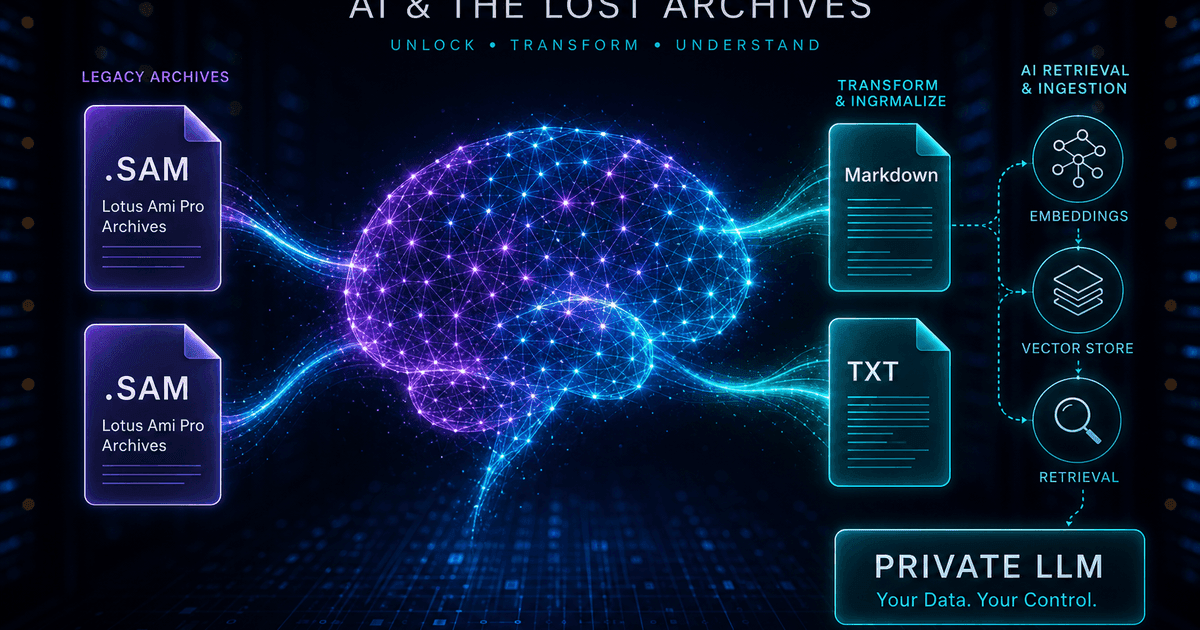
TL;DR
Pour un modèle de langage, votre archive Ami Pro n'existe pas. Convertissez-la en Markdown plutôt qu'en PDF : les titres restent sous forme de structure qu'un découpeur peut exploiter, les tableaux restent lisibles, les équations arrivent en LaTeX, et vous évitez le bruit d'extraction que les pipelines PDF introduisent. Découpez par titre, ajoutez des métadonnées pour le filtrage, intégrez localement, et gardez l'ensemble du pipeline hors ligne : la même confidentialité qui rend un système RAG privé digne d'être construit s'applique à l'étape de conversion. Commencez par Ami Pro Converter.
Le problème du corpus invisible
Les organisations qui construisent des assistants IA internes découvrent généralement le même écart. Le système répond aux questions sur tout ce qui a été écrit au cours des quinze dernières années et reste muet sur tout ce qui est plus ancien, car le matériel plus ancien est dans des formats qu’aucune chaîne d’ingestion ne peut lire. Pour les institutions qui utilisaient Ami Pro au début des années 1990, cela peut signifier que toute la période de fondation d’une politique, d’un produit ou d’une position juridique est manquante.
La conséquence est plus subtile qu'un index incomplet. Un système de recherche qui manque silencieusement de contexte historique ne dit pas « Je n'ai pas cela » ; il répond à partir de ce qu'il possède, avec confiance, et la réponse omet le raisonnement qui a façonné tout depuis. Personne ne le remarque, car le vide est invisible de l'extérieur.
Convertir l'archive héritée n'est donc pas un exercice de rangement. C'est la différence entre un assistant qui sait pourquoi les décisions ont été prises et un qui ne connaît que l'état actuel.
Pourquoi Markdown, pas PDF
L'instinct est de tout convertir en PDF parce que PDF est le paramètre par défaut pour l'archivage, puis d'exécuter l'extraction PDF dans le pipeline. C'est la blessure la plus courante auto-infligée dans les projets RAG sur du contenu hérité, car vous convertissez la structure en mise en page et payez ensuite pour deviner la structure à nouveau.
L'extraction PDF réintroduit tous les artefacts de mise en page comme du bruit : confusion de l'ordre des colonnes, en-têtes et pieds de page apparaissant au milieu du paragraphe, césures scindant les mots, et tableaux s'effondrant en flux de chiffres sans association de lignes ou de colonnes. Le modèle raisonne ensuite sur ce désordre.
Markdown va dans l'autre sens. Parce que les documents Ami Pro contiennent des informations de style explicites dans leurs feuilles .STY, les titres peuvent être émis en tant que véritables titres Markdown, les listes en tant que listes, et les tableaux en tant que tableaux avec des barres verticales. Votre séparateur de texte obtient une structure réelle, vos embeddings obtiennent du texte clair, et vous ne dépensez rien pour les heuristiques d'extraction.
Un pipeline qui fonctionne
1. Inventorier l'archive
Trouvez chaque fichier .sam incluant les variantes en majuscules .SAM, confirmez que les feuilles de style .STY sont présentes, et enregistrez le nombre. Sans feuilles de style, votre Markdown perd la structure des titres, ce qui est la seule chose pour laquelle vous effectuez la conversion.
2. Convertir en Markdown, et TXT pour triage
Émettez les deux en une seule passe. Markdown alimente l'index ; le texte brut vous offre un moyen rapide de parcourir le corpus, de repérer les quasi-doublons et d'identifier les documents vides ou modèles avant de dépenser votre budget d'encodage sur eux.
3. Diviser par titre, pas par nombre de caractères
Le découpage en morceaux de taille fixe coupe à travers le milieu des arguments. Divisez aux limites des titres avec un chevauchement modeste afin que chaque morceau soit une unité cohérente, et intégrez le chemin des titres dans le texte du morceau afin que la récupération sache d'où il provient.
4. Joindre des métadonnées pour le filtrage
Étiquetez chaque morceau avec le nom du fichier source, la date du document, le département et le chemin du dossier. Les corpus historiques rendent le filtrage des métadonnées essentiel — « que disait la politique de 1996 » est un filtre plus une recherche, et non une recherche seule.
5. Intégrer et indexer localement
Exécutez un modèle d'intégration local et stockez les vecteurs dans pgvector, Chroma, Qdrant ou similaire. Si la confidentialité est la raison pour laquelle vous construisez un système privé, envoyer le corpus à une API d'intégration hébergée annule le principe.
Qu'est-ce qui rend les documents anciens spéciaux à indexer
Les anciens documents sont denses en références à des choses qui n'existent plus : noms de départements remplacés, codes de produits abandonnés, anciens intitulés de postes, numéros de réglementations obsolètes. Un modèle ne peut pas les résoudre seul, et un utilisateur posant une question moderne n'utilisera pas le vocabulaire historique.
La solution de mitigation peu coûteuse consiste en un petit glossaire intégré dans l'invite du système, faisant correspondre les anciens noms aux noms actuels. Cela ne coûte presque rien et améliore considérablement le rappel sur un corpus historique.
L'autre caractéristique est que les documents anciens sont souvent remplacés mais non marqués comme tels. Une procédure de 1994 et son remplacement de 2003 semblent tout aussi autoritaires pour un système de récupération. Les métadonnées de date plus une instruction explicite de préférer les sources récentes et d'indiquer la date de toute réponse historique empêchent le mode de défaillance le plus dommageable : citer une politique abrogée comme étant actuelle.
Tables et équations dans un pipeline d'IA
Les tableaux sont l'endroit où le choix du format rapporte le plus visiblement. Un tableau à tuyaux Markdown conserve l'association entre une valeur, son en-tête de colonne et l'étiquette de sa ligne, de sorte qu'un modèle peut répondre à des questions sur une cellule spécifique. Le même tableau extrait d'un PDF est fréquemment une séquence de nombres avec les en-têtes détachés — et un modèle invité à l'interpréter devinera.
Les équations se comportent de manière similaire. Récupérées sous forme d'images rendues, elles sont invisibles pour la recherche de texte et pour le modèle ; récupérées sous forme de LaTeX, elles sont consultables, intégrables et re-rendables. Pour les archives techniques — calculs d'ingénierie, articles académiques, notes actuarielles — l'extraction en LaTeX est ce qui rend le corpus réellement interrogeable plutôt que simplement présent.
Lorsqu'un document est fondamentalement visuel, acceptez-le. Convertissez-le en PDF pour la lecture humaine, indexez le texte qu'il contient et enregistrez dans les métadonnées que le contenu est graphique afin que la recherche puisse diriger une personne vers l'original plutôt que de prétendre le résumer.
Gardez toute la chaîne hors ligne
La plupart des projets RAG privés existent précisément parce que le matériel ne peut pas être confié à un tiers. Il est intéressant de remarquer quand l'étape de conversion enfreint silencieusement cette règle : utiliser un convertisseur en ligne pour préparer des documents pour un système dont le but entier est la confidentialité est une contradiction qui a tendance à persister parce que la conversion est considérée comme de la plomberie plutôt que comme du traitement.
Un convertisseur de bureau local maintient intacte la chaîne de garde du fichier .sam jusqu'au magasin vectoriel. Rien n'est transmis, donc il n'y a aucun transfert à évaluer ou à documenter, et le pipeline peut fonctionner sur une station de travail isolée si le matériel l'exige.
Associez cela à un modèle d'embedding local et à une base de données vectorielle auto-hébergée, et vous obtenez un système que vous pouvez décrire honnêtement lors d'un examen de conformité : le corpus n'a jamais quitté le réseau à aucune étape.
Pourquoi partir du Markdown plutôt que du PDF pour le RAG
- Les titres survivent en tant que structure : le découpage suit la logique propre du document
- Les tableaux conservent le lien entre en-tête et valeur que l’extraction PDF détruit
- Les équations arrivent en LaTeX : consultables et lisibles par machine, pas en images
- Pas d’étape d’OCR ni de reconstruction de la mise en page : moins de jetons et moins de bruit
- Toute la chaîne reste hors ligne, préservant la confidentialité qui la justifiait
Des décennies de contexte, enfin interrogeables
Les documents les plus précieux dans une organisation sont souvent les plus anciens, car ils expliquent pourquoi les choses sont comme elles sont. Les laisser dans un format illisible signifie que votre système d'IA connaît le présent mais aucune des raisons qui le sous-tendent.
Convertissez l'archive en Markdown avec les feuilles de style appliquées, par section selon les titres, étiquetez avec les dates et les départements, intégrez localement, et dites au modèle d'être explicite sur l'ancienneté de ses sources. Le corpus passe d'invisible à consultable, et il ne quitte jamais votre réseau.
Convertissez vos fichiers
Lectures associées
Rendez votre archive Ami Pro lisible par l'IA
L'essai gratuit convertit jusqu'à 10 .sam fichiers en Markdown avec extraction des équations LaTeX — testez votre découpage avant de vous engager sur l'ensemble du corpus.
Essai gratuit
Fonctionnalités complètes — jusqu'à 10 fichiers
Windows 10 ou 11
Téléchargez l'Installateur Windows pour l'essai complet de 10 fichiers. La même application que vous débloquez avec une licence — 100 % locale sur votre PC.