Forbereder Ami Pro-arkiver for AI og RAG-søk
Tiår med institusjonell kunnskap ligger i et format ingen modell kan lese. Her er pipelinen som endrer det — og hvorfor konverteringstrinnet avgjør hvor bra hele systemet vil være.
TL;DR
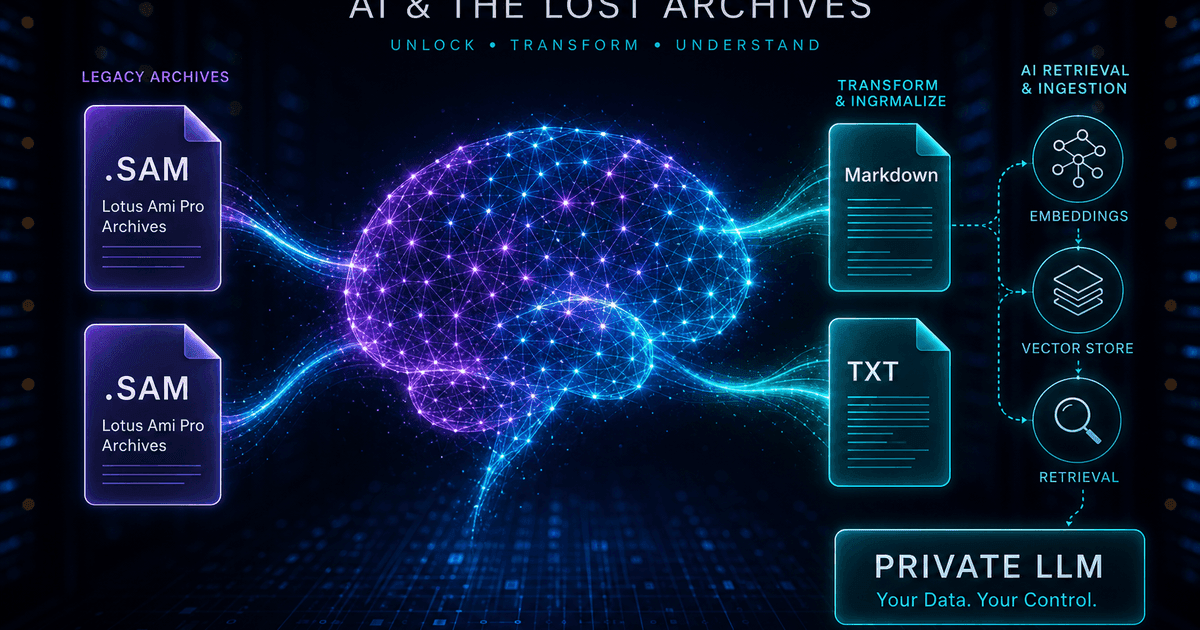
For en språkmodell eksisterer ikke ditt Ami Pro-arkiv. Konverter det til Markdown i stedet for PDF: overskrifter bevares som struktur som en oppdelingsmodul kan dele på, tabeller forblir lesbare, ligninger kommer som LaTeX, og du unngår ekstraksjonsstøy som PDF-pipelines introduserer. Del opp etter overskrifter, legg ved metadata for filtrering, legg inn lokalt, og hold hele prosessen offline — den samme konfidensialiteten som gjør et privat RAG-system verdt å bygge gjelder for konverteringstrinnet. Start med Ami Pro Converter.
Problemet med det usynlige korpuset
Organisasjoner som bygger interne AI-assistenter oppdager vanligvis det samme gapet. Systemet svarer på spørsmål om alt som er skrevet de siste femten årene og blir blankt på alt som er eldre, fordi det eldre materialet er i formater som ingen inntaksrørledning kan lese. For institusjoner som brukte Ami Pro tidlig på 1990-tallet, kan det bety at hele grunnleggingsperioden for en policy, et produkt eller en juridisk posisjon mangler.
Konsekvensen er mer subtil enn et ufullstendig indeks. Et søkesystem som stille mangler historisk kontekst sier ikke «Jeg har ikke det»; det svarer ut fra det det har, med selvsikkerhet, og svaret utelater resonnementet som har formet alt siden. Ingen legger merke til det, fordi gapet er usynlig fra utsiden.
Å konvertere det gamle arkivet er derfor ikke en ryddingsøvelse. Det er forskjellen mellom en assistent som vet hvorfor beslutninger ble tatt og en som bare kjenner den nåværende tilstanden.
Hvorfor Markdown, ikke PDF
Instinktet er å konvertere alt til PDF fordi PDF er arkivstandarden, og deretter kjøre PDF-ekstraksjon i pipelinen. Dette er den vanligste selvpåførte skaden i RAG-prosjekter over eldre innhold, fordi du konverterer struktur til layout og deretter betaler for å gjette strukturen tilbake.
PDF-utvinning introduserer på nytt alle layoutartefakter som støy: forvirring om kolonnerekken, løpende topp- og bunntekst som dukker opp midt i avsnitt, bindestrekslinjeskift som deler ord, og tabeller som kollapser til strømmer av tall uten rad- eller kolonneforbindelse. Modellen resonerer deretter over det rotet.
Markdown går den andre veien. Fordi Ami Pro-dokumenter har eksplisitt stilinformasjon i sine .STY-ark, kan overskrifter utstedes som ekte Markdown-overskrifter, lister som lister, og tabeller som pipe-tabeller. Din chunker får ekte struktur, dine embedding-er får ren tekst, og du bruker ingenting på ekstraksjonsheuristikker.
En pipeline som fungerer
1. Lag en oversikt over arkivet
Finn alle .sam-filer inkludert store bokstaver .SAM-varianter, bekreft at .STY-stilarkene er til stede, og registrer antallet. Uten stilark mister Markdown overskriftsstrukturen, som er det ene du konverterer for.
2. Konverter til Markdown, og TXT for triage
Emit begge på én gang. Markdown gir indeksen; vanlig tekst gir deg en rask måte å søke i korpuset, oppdage nær-duplikater og identifisere tomme eller maldokumenter før du bruker embed-budget på dem.
3. Del opp etter overskrift, ikke etter antall tegn
Fast størrelsesdeling kutter gjennom midten av argumenter. Del på overskriftsgrenser med en moderat overlapping slik at hver del er en sammenhengende enhet, og ta med overskriftsstien inn i delt teksten slik at gjenfinning vet hvor den kom fra.
4. Legg ved metadata for filtrering
Merk hver del med kildefilnavn, dokumentdato, avdeling og mappesti. Historiske korpora gjør metadatafiltrering nødvendig — «hva sa policyen fra 1996» er et filter pluss et søk, ikke bare et søk.
5. Bygg inn og indekser lokalt
Kjør en lokal embedding-modell og lagre vektorene i pgvector, Chroma, Qdrant eller lignende. Hvis konfidensialitet er grunnen til at du bygger et privat system, vil det å sende korpuset til en hostet embedding-API oppheve premisset.
Hva gjør eldre dokumenter spesielle å indeksere
Gamle dokumenter er fulle av referanser til ting som ikke lenger finnes: overflødige avdelingsnavn, avviklede produktkoder, tidligere stillingstitler, utdaterte forskriftsnumre. En modell kan ikke løse disse alene, og en bruker som stiller et moderne spørsmål, vil ikke bruke det historiske vokabularet.
Den billige avbøtingen er en liten ordliste som injiseres i systemprompten, og som kartlegger gamle navn til dagens. Den koster nesten ingenting og forbedrer dramatisk tilbakehenting på et historisk korpus.
Den andre egenskapen er at eldre dokumenter ofte blir erstattet, men ikke merket som sådan. En prosedyre fra 1994 og dens erstatning fra 2003 ser like autoritative ut for et søkesystem. Datametadata pluss en eksplisitt instruksjon om å foretrekke nyere kilder og å oppgi datoen for ethvert historisk svar forhindrer den mest skadelige feilmodusen: å sitere en opphevet politikk som gjeldende.
Tabeller og ligninger i en AI-rørledning
Tabeller er der formatvalg gir mest synlig uttelling. En Markdown rørledningstabell bevarer forbindelsen mellom en verdi, kolonneoverskriften og radetiketten, slik at en modell kan svare på spørsmål om en spesifikk celle. Den samme tabellen hentet fra en PDF er ofte en sekvens av tall med overskriftene frakoblet — og en modell som blir bedt om å tolke den, vil gjette.
Likninger oppfører seg på lignende måte. Gjenvunnet som gjengitte bilder er de usynlige for tekstsøk og for modellen; gjenvunnet som LaTeX er de søkbare, kan settes inn og gjengis på nytt. For tekniske arkiver — ingeniørberegninger, vitenskapelige artikler, aktuarnotater — er LaTeX-ekstraksjon det som gjør korpuset virkelig søkbart i stedet for bare til stede.
Når et dokument i hovedsak er visuelt, aksepter det. Konverter det til PDF for menneskelig lesing, indekser all tekst det inneholder, og registrer i metadataene at innholdet er grafisk slik at søk kan peke en person til originalen i stedet for å late som det oppsummerer det.
Hold hele rørsystemet frakoblet
De fleste private RAG-prosjekter eksisterer nettopp fordi materialet ikke kan gå til en tredjepart. Det er verdt å legge merke til når konverteringstrinnet stille bryter den regelen: å bruke en nettbasert konverter til å forberede dokumenter for et system hvis hele formål er konfidensialitet, er en motsigelse som har en tendens til å overleve fordi konvertering behandles som rørlegging snarere enn som behandling.
En lokal skrivebordsomformer holder beviskjeden intakt fra .sam-fil til vektorlager. Ingenting sendes, så det er ingen overføring å vurdere eller dokumentere, og prosesslinjen kan kjøres på en isolert arbeidsstasjon hvis det er det materialet krever.
Kombiner det med en lokal innebyggingsmodell og en selvhostet vektordatabasen, så har du et system du kan beskrive ærlig i en samsvarsrevisjon: korpuset forlot aldri nettverket på noe tidspunkt.
Derfor slår Markdown først PDF først for RAG
- Overskrifter bevares som struktur, så oppdelingen følger dokumentets egen logikk
- Tabeller beholder forbindelsen mellom overskrift og verdi som PDF-uttrekk ødelegger
- Formler kommer som LaTeX – søkbare og maskinlesbare, ikke bilder
- Ingen OCR eller gjenoppbygging av oppsett, så færre tokens og mindre støy
- Hele prosessen forblir uten nett og bevarer fortroligheten som begrunnet den
Tiår med kontekst, endelig søkbar
De mest verdifulle dokumentene i en organisasjon er ofte de eldste, fordi de registrerer hvorfor ting er som de er. Å la dem være i et format som ingen kan lese, betyr at AI-systemet ditt kjenner nåtiden, men ingen av grunnene bak den.
Konverter arkivet til Markdown med stilarkene brukt, delt opp etter overskrift, merk med datoer og avdelinger, legg inn lokalt, og fortell modellen å være eksplisitt om hvor gamle kildene dens er. Korpuset går fra usynlig til søkbart, og det forlater aldri nettverket ditt.
Konverter filene dine
Relatert lesing
Gjør ditt Ami Pro-arkiv AI-lesbart
Gratis prøveversjon konverterer opptil 10 .sam filer til Markdown med LaTeX-likningsuttrekking — test oppdelingen din før du forplikter deg til hele korpuset.
Gratis prøveversjon
Alle app-funksjoner — opptil 10 filer
Windows 10 eller 11
Last ned Windows-installasjonsprogram for den fullstendige 10-filers prøveversjonen. Samme app som du låser opp med en lisens — 100 % lokalt på PC-en din.