Het Voorbereiden van Ami Pro Archieven voor AI en RAG Zoeken
Decennia aan institutionele kennis zit in een formaat dat geen enkel model kan lezen. Hier is de pijplijn die dat verandert — en waarom de conversiestap bepaalt hoe goed het hele systeem zal zijn.
TL;DR
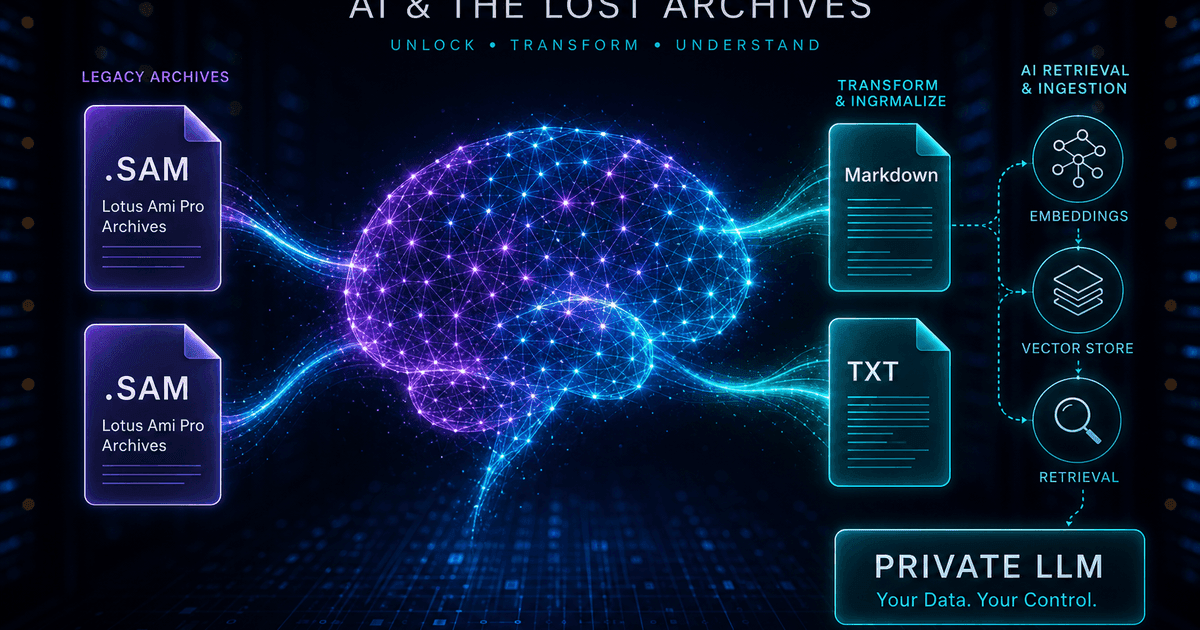
Voor een taalmodel bestaat je Ami Pro-archief niet. Converteer het naar Markdown in plaats van PDF: koppen blijven bewaard als structuur waar een chunker op kan splitsen, tabellen blijven leesbaar, vergelijkingen komen aan als LaTeX, en je voorkomt het extractiegeluid dat PDF-pijplijnen introduceren. Splits op kop, voeg metadata toe voor filtering, embed lokaal, en houd de hele pijplijn offline — dezelfde vertrouwelijkheid die een privaat RAG-systeem de moeite waard maakt om te bouwen, geldt voor de conversiestap. Begin met Ami Pro Converter.
Het onzichtbare corpusprobleem
Organisaties die interne AI-assistenten bouwen, ontdekken meestal dezelfde kloof. Het systeem beantwoordt vragen over alles wat in de afgelopen vijftien jaar is geschreven en reageert niet op oudere zaken, omdat het oudere materiaal in formaten staat die geen enkel innameproces kan lezen. Voor instellingen die Ami Pro in het begin van de jaren 90 gebruikten, kan dat betekenen dat de hele oprichtingsperiode van een beleid, product of juridische positie ontbreekt.
Het gevolg is subtieler dan een onvolledige index. Een zoekmachine die stilletjes historische context mist, zegt niet 'Dat heb ik niet'; ze geeft een antwoord op basis van wat ze heeft, vol vertrouwen, en het antwoord laat de redenering weg die alles sinds heeft gevormd. Niemand merkt het, omdat de kloof van buitenaf onzichtbaar is.
Het converteren van het legacy-archief is daarom geen opruimexercise. Het is het verschil tussen een assistent die weet waarom beslissingen zijn genomen en een die alleen de huidige staat kent.
Waarom Markdown, niet PDF
De instinct is om alles om te zetten naar PDF omdat PDF de archiveringsstandaard is, en vervolgens PDF-extractie in de pijplijn uit te voeren. Dit is het meest voorkomende zelf toegebrachte probleem in RAG-projecten over legacy-inhoud, omdat je structuur omzet in lay-out en daarna betaalt om de structuur weer terug te raden.
PDF-extractie herintroduceert elk lay-outartefact als ruis: verwarring over de kolomvolgorde, kop- en voetteksten die midden in een alinea verschijnen, afgebroken regels met koppelteken die woorden splitsen, en tabellen die instorten tot reeksen getallen zonder rij- of kolomassociatie. Het model redeneert vervolgens over die rommel.
Markdown gaat de andere kant op. Omdat Ami Pro-documenten expliciete stijlgegevens bevatten in hun .STY-sheets, kunnen koppen als echte Markdown-koppen worden uitgegeven, lijsten als lijsten, en tabellen als pipetabellen. Je chunker krijgt echte structuur, je embeddings krijgen schone tekst, en je besteedt niets aan extractieheuristieken.
Een pijplijn die werkt
1. Inventariseer het archief
Vind elk .sam-bestand inclusief hoofdletter .SAM-varianten, bevestig dat de .STY-stijlbladen aanwezig zijn, en noteer het aantal. Zonder stijlbladen verliest je Markdown de kopstructuur, wat het enige is waarvoor je aan het converteren bent.
2. Converteer naar Markdown, en TXT voor triage
Zend beide in één keer uit. Markdown voedt de index; gewone tekst geeft je een snelle manier om het corpus te doorzoeken, bijna-duplicaten te herkennen en lege of sjabloondocumenten te identificeren voordat je er embedding budget aan besteedt.
3. Per kop verdelen, niet per aantal tekens
Vast-grootte opsplitsing snijdt door het midden van argumenten. Splits op kopgrenslijnen met een bescheiden overlap zodat elke chunk een samenhangende eenheid is, en neem het kopjespad mee in de chunktekst zodat het ophalen weet waar het vandaan kwam.
4. Voeg metadata toe voor filtering
Label elk stuk met de bronbestandsnaam, documentdatum, afdeling en mappad. Historische corpora maken het filteren op metadata essentieel — “wat zei het beleid van 1996” is een filter plus een zoekopdracht, niet alleen een zoekopdracht.
5. Lokaal insluiten en indexeren
Voer een lokaal embedding-model uit en sla vectoren op in pgvector, Chroma, Qdrant of iets soortgelijks. Als vertrouwelijkheid de reden is dat je een privé-systeem bouwt, haalt het verzenden van de corpus naar een gehoste embedding-API de reden teniet.
Wat maakt legacy-documenten speciaal om te indexeren
Oude documenten zitten vol met verwijzingen naar dingen die niet langer bestaan: verouderde afdelingsnamen, stopgezette productcodes, voormalige functietitels, achterhaalde regelnummers. Een model kan die niet zelfstandig oplossen, en een gebruiker die een moderne vraag stelt, zal het historische vocabulaire niet gebruiken.
De goedkope maatregel is een kleine glossarium die in de systeemprompt wordt geïnjecteerd, waarin oude namen aan huidige worden gekoppeld. Het kost bijna niets en verbetert de herinnering aan een historisch corpus drastisch.
Een andere eigenschap is dat legacy-documenten vaak worden vervangen, maar niet als zodanig worden gemarkeerd. Een procedure uit 1994 en de vervanging ervan in 2003 lijken even gezaghebbend voor een opslagsysteem. Datum-metadata plus een expliciete instructie om recente bronnen te prefereren en de datum van elk historisch antwoord te vermelden, voorkomt de meest schadelijke faalmethode: het citeren van een ingetrokken beleid alsof het nog actueel is.
Tabellen en vergelijkingen in een AI-pijplijn
Tabellen zijn waar de keuze van het formaat het meest zichtbaar loont. Een Markdown pijptabel houdt de associatie tussen een waarde, de kolomkop en het rijlabel bij, zodat een model vragen over een specifieke cel kan beantwoorden. Dezelfde tabel, geëxtraheerd uit een PDF, is vaak een reeks nummers waarvan de koppen losstaan — en een model dat gevraagd wordt deze te interpreteren, zal raden.
Vergelijkingen gedragen zich op een vergelijkbare manier. Hersteld als weergegeven afbeeldingen zijn ze onzichtbaar voor tekstopzoekingen en voor het model; hersteld als LaTeX zijn ze doorzoekbaar, insluitbaar en opnieuw weer te geven. Voor technische archieven — engineering berekeningen, academische papers, actuarieel aantekeningen — is LaTeX-extractie wat het corpus daadwerkelijk doorzoekbaar maakt in plaats van slechts aanwezig.
Waar een document fundamenteel visueel is, accepteer het. Converteer het naar PDF voor menselijke lezing, indexeer welke tekst het ook bevat, en registreer in de metadata dat de inhoud grafisch is, zodat bij het ophalen een persoon naar het origineel kan worden geleid in plaats van te doen alsof het wordt samengevat.
Houd de hele pijplijn offline
De meeste particuliere RAG-projecten bestaan precies omdat het materiaal niet naar een derde mag gaan. Het is de moeite waard op te merken wanneer de conversiestap stilletjes die regel overtreedt: het gebruik van een webgebaseerde converter om documenten voor te bereiden voor een systeem waarvan het hele doel vertrouwelijkheid is, is een contradictie die vaak blijft bestaan omdat conversie wordt behandeld als infrastructuur in plaats van als verwerking.
Een lokale desktopconverter houdt de keten van bewaring intact van het .sam-bestand tot de vectoropslag. Er wordt niets verzonden, dus er is geen overdracht om te beoordelen of te documenteren, en de pijplijn kan draaien op een geïsoleerd werkstation als dat is wat het materiaal vereist.
Koppel dat aan een lokaal embeddingmodel en een zelfgehoste vectordatabank en je hebt een systeem dat je eerlijk kunt beschrijven in een compliancebeoordeling: het corpus heeft het netwerk op geen enkel moment verlaten.
Waarom Markdown eerst beter werkt dan PDF eerst voor RAG
- Koppen blijven behouden als structuur, zodat het opdelen de logica van het document volgt
- Tabellen houden de relatie tussen kop en waarde vast die PDF-extractie vernietigt
- Formules komen binnen als LaTeX – doorzoekbaar en machineleesbaar, geen plaatjes
- Geen OCR- of opmaakreconstructiestap, dus minder tokens en minder ruis
- De hele keten blijft offline en behoudt de vertrouwelijkheid die ervoor de reden was
Decennia aan context, eindelijk doorzoekbaar
De meest waardevolle documenten in een organisatie zijn vaak de oudste, omdat ze vastleggen waarom dingen zijn zoals ze zijn. Ze in een formaat laten staan dat niemand kan lezen, betekent dat je AI-systeem het heden kent en geen van de achterliggende redenen ervan.
Converteer het archief naar Markdown met de stijlbladen toegepast, opgedeeld per kop, label met datums en afdelingen, lokaal insluiten, en vertel het model om expliciet te zijn over hoe oud zijn bronnen zijn. Het corpus gaat van onzichtbaar naar doorzoekbaar, en het verlaat nooit je netwerk.
Converteer je bestanden
Gerelateerd lezen
Maak je Ami Pro-archief AI-leesbaar
Gratis proefversie converteert tot 10 .sam bestanden naar Markdown met LaTeX-vergelijkingsextractie — test je opsplitsing voordat je je aan het volledige corpus bindt.
Gratis proefversie
Alle app-functies — tot 10 bestanden
Windows 10 of 11
Download het Windows-installatieprogramma voor de volledige proefversie van 10 bestanden. Dezelfde app die je ontgrendelt met een licentie — 100 % lokaal op je PC.