Preparar Ficheiros Ami Pro para Pesquisa IA e RAG
Décadas de conhecimento institucional estão num formato que nenhum modelo consegue ler. Aqui está o fluxo de trabalho que muda isso — e porque é que a etapa de conversão decide quão bom será todo o sistema.
TL;DR
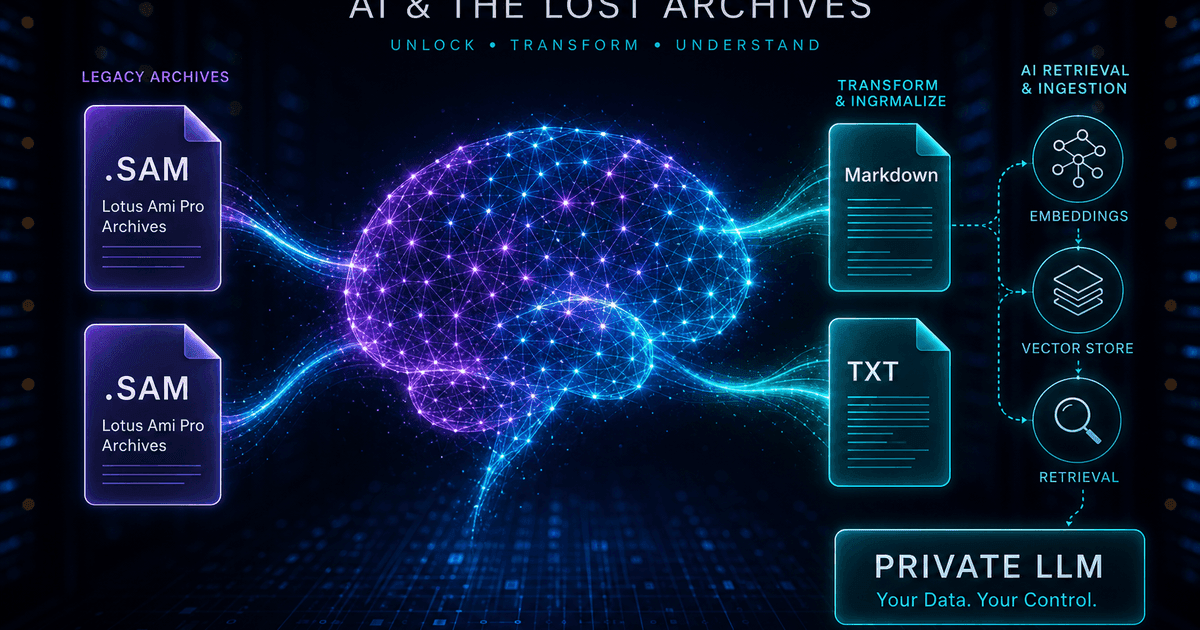
Para um modelo de linguagem, o seu ficheiro Ami Pro não existe. Converta-o para Markdown em vez de PDF: os títulos sobrevivem como estrutura que um segmentador pode dividir, as tabelas permanecem legíveis, as equações chegam como LaTeX, e evita-se o ruído de extração que os pipelines PDF introduzem. Segmente por título, anexe metadados para filtragem, incorpore localmente e mantenha todo o processo offline — a mesma confidencialidade que torna um sistema RAG privado digno de ser construído aplica-se à etapa de conversão. Comece com Ami Pro Converter.
O problema do corpus invisível
As organizações que desenvolvem assistentes internos de IA geralmente descobrem a mesma lacuna. O sistema responde a perguntas sobre qualquer coisa escrita nos últimos quinze anos e fica em branco quanto a qualquer material mais antigo, porque o material mais antigo está em formatos que nenhum pipeline de ingestão consegue ler. Para instituições que utilizavam Ami Pro no início dos anos 1990, isso pode significar que todo o período de fundação de uma política, produto ou posição legal está em falta.
A consequência é mais subtil do que um índice incompleto. Um sistema de recuperação que silenciosamente carece de contexto histórico não diz "Não tenho isso"; responde com base no que tem, com confiança, e a resposta omite o raciocínio que moldou tudo desde então. Ninguém repara, porque a lacuna é invisível do exterior.
Converter o ficheiro legado não é, portanto, um exercício de arrumação. É a diferença entre um assistente que sabe por que as decisões foram tomadas e um que apenas conhece o estado atual.
Por que Markdown, e não PDF
O instinto é converter tudo para PDF porque PDF é o padrão de arquivamento, e depois executar a extração de PDF na pipeline. Esta é a ferida auto-infligida mais comum em projetos RAG sobre conteúdo legado, porque si converte estrutura em layout e depois paga para adivinhar a estrutura de volta.
A extração PDF reintroduz todos os artefactos de layout como ruído: confusão na ordem das colunas, cabeçalhos e rodapés a aparecer no meio do parágrafo, quebras de linha com hífen a dividir palavras, e tabelas a colapsar em fluxos de números sem qualquer associação de linhas ou colunas. O modelo depois raciocina sobre essa confusão.
Markdown vai na direção oposta. Porque os documentos Ami Pro contêm informação de estilo explícita nas suas folhas .STY, os títulos podem ser emitidos como verdadeiros títulos Markdown, listas como listas e tabelas como tabelas de tubos. O seu segmentador obtém estrutura genuína, os seus embeddings obtêm texto limpo, e não gasta nada em heurísticas de extração.
Um pipeline que funciona
1. Inventariar o ficheiro
Encontre todos os ficheiros .sam, incluindo variantes em maiúsculas de .SAM, confirme que as folhas de estilo .STY estão presentes e registe a contagem. Sem folhas de estilo, o seu Markdown perde a estrutura de cabeçalho, que é a única coisa para a qual está a converter.
2. Converter para Markdown, e TXT para triagem
Emita ambos de uma só vez. Markdown alimenta o índice; o texto simples dá-lhe uma forma rápida de pesquisar no corpus, identificar quase-duplicados e localizar documentos vazios ou de modelo antes de gastar orçamento de incorporação neles.
3. Divida por título, não por contagem de caracteres
A divisão em blocos de tamanho fixo corta pelo meio dos argumentos. Divida nos limites dos cabeçalhos com uma sobreposição modesta para que cada bloco seja uma unidade coerente, e leve o caminho do cabeçalho para dentro do texto do bloco para que a recuperação saiba de onde ele veio.
4. Anexar metadados para filtragem
Marque cada segmento com o nome do ficheiro de origem, data do documento, departamento e caminho da pasta. Corpora históricos tornam a filtragem por metadados essencial — "o que dizia a política de 1996" é um filtro mais uma pesquisa, não apenas uma pesquisa.
5. Incorporar e indexar localmente
Execute um modelo de embeddings local e armazene vetores em pgvector, Chroma, Qdrant ou semelhante. Se a confidencialidade é a razão pela qual está a construir um sistema privado, enviar o corpus para uma API de embeddings hospedada anula o princípio.
O que torna os documentos legados especiais para indexar
Documentos antigos estão repletos de referências a coisas que já não existem: nomes de departamentos substituídos, códigos de produtos descontinuados, cargos antigos, números de regulamentos obsoletos. Um modelo não consegue resolver isso por si só, e um utilizador a fazer uma pergunta moderna não usará o vocabulário histórico.
A mitigação barata é um pequeno glossário inserido no prompt do sistema, mapeando nomes antigos para os atuais. Custa quase nada e melhora drasticamente a recuperação num corpus histórico.
A outra característica é que os documentos antigos são frequentemente substituídos, mas não assinalados como tal. Um procedimento de 1994 e a sua substituição de 2003 parecem igualmente autoritativos para um sistema de recuperação. Os metadados de data, juntamente com uma instrução explícita para preferir fontes recentes e para indicar a data de qualquer resposta histórica, evitam o modo de falha mais prejudicial: citar uma política revogada como atual.
Tabelas e equações numa linha de processamento de IA
As tabelas são o local onde a escolha do formato compensa mais visivelmente. Uma tabela de tubos Markdown mantém a associação entre um valor, o cabeçalho da sua coluna e a etiqueta da sua linha, de modo que um modelo pode responder a perguntas sobre uma célula específica. A mesma tabela extraída de um PDF é frequentemente uma sequência de números com os cabeçalhos separados — e um modelo solicitado a interpretá-la irá adivinhar.
As equações comportam-se de forma semelhante. Recuperadas como imagens renderizadas, são invisíveis para a pesquisa de texto e para o modelo; recuperadas como LaTeX, são pesquisáveis, integráveis e reutilizáveis. Para ficheiros técnicos — cálculos de engenharia, artigos académicos, notas atuariais — a extração em LaTeX é o que torna o corpus verdadeiramente interrogável, e não apenas presente.
Quando um documento for fundamentalmente visual, aceite-o. Converta-o para PDF para leitura humana, indexe o texto que contiver e registe nos metadados que a substância é gráfica, de modo que a recuperação possa indicar a uma pessoa o original em vez de fingir resumir.
Mantenha toda a linha de produção offline
A maioria dos projetos privados de RAG existe precisamente porque o material não pode ser enviado a terceiros. Vale a pena notar quando a etapa de conversão quebra silenciosamente essa regra: usar um conversor baseado na web para preparar documentos para um sistema cujo propósito inteiro é a confidencialidade é uma contradição que tende a persistir porque a conversão é tratada como canalização em vez de processamento.
Um conversor de ambiente local mantém a cadeia de custódia intacta desde o ficheiro .sam até ao armazenamento de vetores. Nada é transmitido, por isso não há transferência a avaliar ou documentar, e a linha de processamento pode ser executada numa estação de trabalho isolada, se for isso que o material exigir.
Combine isso com um modelo de embeddings local e uma base de dados vetorial auto-hospedada e si tem um sistema que pode descrever honestamente numa revisão de conformidade: o corpus nunca saiu da rede em nenhum momento.
Porque é que começar pelo Markdown supera começar pelo PDF em RAG
- Os títulos sobrevivem como estrutura, pelo que a segmentação segue a lógica do próprio documento
- As tabelas mantêm a relação entre cabeçalho e valor que a extração de PDF destrói
- As equações chegam em LaTeX: pesquisáveis e legíveis por máquina, não imagens
- Sem fase de OCR nem de reconstrução do esquema, logo menos tokens e menos ruído
- Todo o processo fica offline, preservando a confidencialidade que o justificou
Décadas de contexto, finalmente consultáveis
Os documentos mais valiosos numa organização são frequentemente os mais antigos, porque regem porque as coisas são como são. Deixá-los num formato que ninguém consegue ler significa que o seu sistema de IA conhece o presente e nenhuma das razões por trás dele.
Converta o ficheiro para Markdown com as folhas de estilo aplicadas, dividido por cabeçalhos, etiquetado com datas e departamentos, incorporado localmente, e diga ao modelo para ser explícito sobre a idade das suas fontes. O corpus passa de invisível a pesquisável, e nunca sai da sua rede.
Converta os seus ficheiros
Leitura relacionada
Torne o seu ficheiro Ami Pro legível por IA
O teste gratuito converte até 10 .sam ficheiros para Markdown com extração de equações LaTeX — teste o seu segmentamento antes de se comprometer com o corpus completo.
Teste gratuito
Funcionalidades completas da aplicação — até 10 ficheiros
Windows 10 ou 11
Descarregue o Instalador Windows para o teste completo de 10 ficheiros. A mesma aplicação que desbloqueia com uma licença — 100 % local no seu PC.