Vorbereitung von Ami Pro-Archiven für KI- und RAG-Suche
Jahrzehnte institutionellen Wissens liegen in einem Format vor, das kein Modell lesen kann. Hier ist die Pipeline, die das ändert – und warum der Konvertierungsschritt entscheidet, wie gut das gesamte System sein wird.
TL;DR
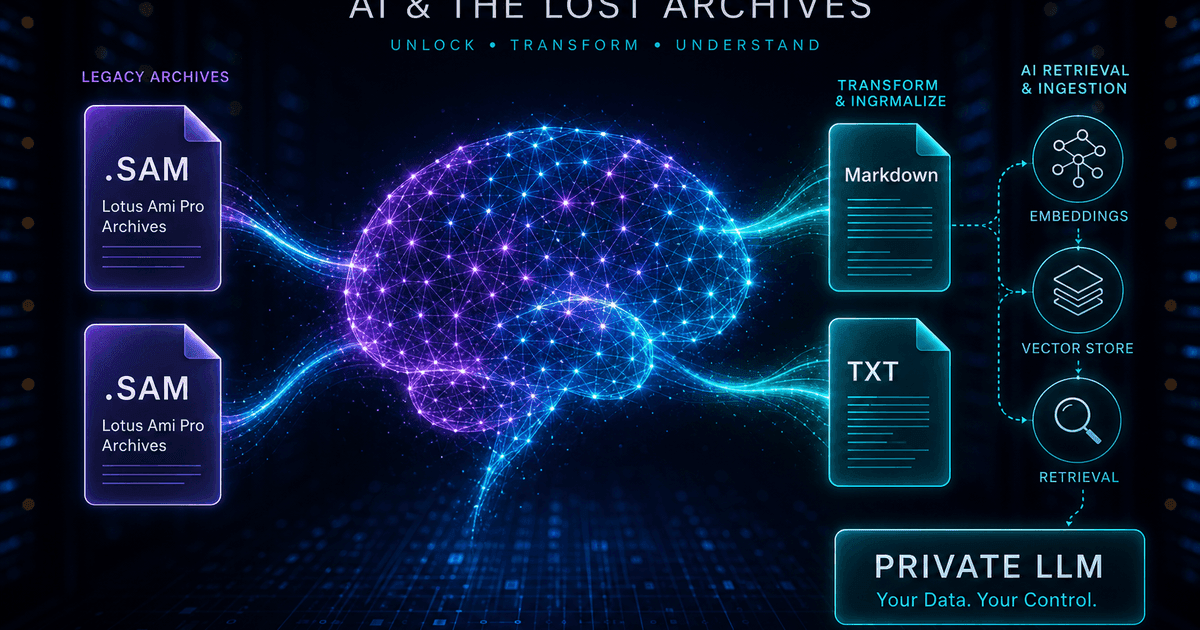
Für ein Sprachmodell existiert Ihr Ami Pro-Archiv nicht. Konvertieren Sie es in Markdown statt in PDF: Überschriften bleiben als Struktur erhalten, auf die ein Chunker aufteilen kann, Tabellen bleiben lesbar, Gleichungen werden als LaTeX übertragen, und Sie vermeiden das Extraktionsrauschen, das PDF-Pipelines einführen. Nach Überschriften chunken, Metadaten zur Filterung anhängen, lokal einbetten und die gesamte Pipeline offline halten — dieselbe Vertraulichkeit, die ein privates RAG-System wertvoll macht, gilt auch für den Konvertierungsschritt. Beginnen Sie mit Ami Pro Converter.
Das unsichtbare Korpusproblem
Organisationen, die interne KI-Assistenten aufbauen, entdecken in der Regel dieselbe Lücke. Das System beantwortet Fragen zu allem, was in den letzten fünfzehn Jahren geschrieben wurde, und bleibt bei allem Älteren leer, weil das ältere Material in Formaten vorliegt, die keine Aufnahme-Pipeline lesen kann. Für Institutionen, die Ami Pro Anfang der 1990er Jahre nutzten, kann das bedeuten, dass die gesamte Gründungsperiode einer Richtlinie, eines Produkts oder einer Rechtsposition fehlt.
Die Konsequenz ist subtiler als ein unvollständiger Index. Ein Abrufsystem, das stillschweigend historischen Kontext vermisst, sagt nicht „Das habe ich nicht“; es antwortet aus dem, was es hat, selbstbewusst, und die Antwort lässt die Überlegungen weg, die alles seitdem geprägt haben. Niemand bemerkt es, weil die Lücke von außen unsichtbar ist.
Die Umwandlung des alten Archivs ist daher keine Aufräumaktion. Es ist der Unterschied zwischen einem Assistenten, der weiß, warum Entscheidungen getroffen wurden, und einem, der nur den aktuellen Zustand kennt.
Warum Markdown, nicht PDF
Der Instinkt besteht darin, alles in PDF umzuwandeln, weil PDF der archivierungsbezogene Standard ist, und dann die PDF-Extraktion in der Pipeline auszuführen. Dies ist die häufigste selbst zugefügte Wunde in RAG-Projekten mit altem Inhalt, weil man Struktur in Layout umwandelt und dann dafür bezahlt, die Struktur zurückzuraten.
Die PDF-Extraktion führt jedes Layout-Artefakt als Rauschen wieder ein: Spaltenreihenfolge-Verwirrung, laufende Kopf- und Fußzeilen, die mitten im Absatz erscheinen, durch Bindestriche getrennte Zeilenumbrüche, die Wörter teilen, und Tabellen, die zu Zahlenströmen ohne Zeilen- oder Spaltenzuordnung zusammenfallen. Das Modell folgert dann über dieses Durcheinander.
Markdown geht in die andere Richtung. Da Ami Pro-Dokumente explizite Stilinformationen in ihren .STY-Blättern enthalten, können Überschriften als echte Markdown-Überschriften ausgegeben werden, Listen als Listen und Tabellen als Pipe-Tabellen. Ihr Chunker erhält echte Struktur, Ihre Einbettungen erhalten sauberen Text, und Sie verschwenden nichts für Extraktionsheuristiken.
Eine Pipeline, die funktioniert
1. Inventarisiere das Archiv
Finden Sie jede .sam-Datei, einschließlich Großbuchstaben-.SAM-Varianten, bestätigen Sie, dass die .STY-Stylesheets vorhanden sind, und notieren Sie die Anzahl. Ohne Stylesheets verliert Ihre Markdown die Überschriftenstruktur, was genau das ist, wofür Sie konvertieren.
2. In Markdown umwandeln und TXT für die Triage
Emittieren Sie beides in einem Durchgang. Markdown liefert den Index; Klartext gibt Ihnen eine schnelle Möglichkeit, das Korpus zu durchsuchen, nahezu identische Duplikate zu erkennen und leere oder Vorlagendokumente zu identifizieren, bevor Sie Ihr Einbettungsbudget dafür ausgeben.
3. Nach Überschrift aufteilen, nicht nach Zeichenanzahl
Festgrößen-Chunking schneidet mitten durch Argumente. Teile an Überschriftenbegrenzungen mit einem moderaten Überlappen, sodass jeder Chunk eine zusammenhängende Einheit ist, und übertrage den Überschriftenpfad in den Chunk-Text, damit die Suche weiß, woher er stammt.
4. Metadaten zur Filterung anhängen
Markiere jeden Abschnitt mit dem Quell-Dateinamen, dem Dokumentdatum, der Abteilung und dem Ordnerpfad. Historische Korpora machen die Metadatenfilterung unverzichtbar — „Was sagte die Richtlinie von 1996“ ist ein Filter plus eine Suche, nicht nur eine Suche.
5. Lokal einbetten und indexieren
Führen Sie ein lokales Embedding-Modell aus und speichern Sie Vektoren in pgvector, Chroma, Qdrant oder ähnlichem. Wenn Vertraulichkeit der Grund dafür ist, dass Sie ein privates System aufbauen, hebt das Senden des Korpus an eine gehostete Embedding-API das Prinzip auf.
Was macht Altdokumente besonders zum Indexieren
Alte Dokumente sind dicht mit Verweisen auf Dinge, die nicht mehr existieren: veraltete Abteilungsnamen, eingestellte Produktcodes, frühere Berufsbezeichnungen, obsolet gewordene Regulierungsnummern. Ein Modell kann diese nicht eigenständig auflösen, und ein Benutzer, der eine moderne Frage stellt, wird nicht das historische Vokabular verwenden.
Die günstige Maßnahme besteht darin, ein kleines Glossar in das Systemprompt einzufügen, das alte Namen den aktuellen zuordnet. Es kostet fast nichts und verbessert die Erinnerung an ein historisches Korpus dramatisch.
Das andere Merkmal ist, dass ältere Dokumente oft ersetzt werden, aber nicht als solche gekennzeichnet sind. Ein Verfahren von 1994 und dessen Ersatz von 2003 erscheinen einem Abrufsystem gleichermaßen maßgeblich. Datums-Metadaten plus eine ausdrückliche Anweisung, neuere Quellen zu bevorzugen und das Datum jeder historischen Antwort anzugeben, verhindern die schädlichste Ausfallart: eine aufgehobene Richtlinie als aktuell zu zitieren.
Tabellen und Gleichungen in einer KI-Pipeline
Tabellen sind der Ort, an dem sich die Formatwahl am sichtbarsten auszahlt. Eine Markdown-Rohrleitungstabelle bewahrt die Zuordnung zwischen einem Wert, seinem Spaltenkopf und seinem Zeilenlabel, sodass ein Modell Fragen zu einer bestimmten Zelle beantworten kann. Dieselbe aus einer PDF extrahierte Tabelle ist häufig eine Zahlenreihe mit abgetrennten Überschriften – und ein Modell, das gebeten wird, sie zu interpretieren, wird raten.
Gleichungen verhalten sich ähnlich. Als gerenderte Bilder wiederhergestellt, sind sie für die Textsuche und das Modell unsichtbar; als LaTeX wiederhergestellt, sind sie durchsuchbar, einbettbar und erneut rendrierbar. Für technische Archive — Ingenieursberechnungen, wissenschaftliche Arbeiten, Aktuarunterlagen — ist die LaTeX-Extraktion das, was das Korpus wirklich abfragbar macht und nicht nur präsent.
Wenn ein Dokument grundsätzlich visuell ist, akzeptieren Sie es. Konvertieren Sie es zu PDF für die menschliche Lesung, indexieren Sie den Text, den es enthält, und vermerken Sie in den Metadaten, dass der Inhalt grafisch ist, damit die Suche eine Person auf das Original verweisen kann, anstatt vorzugeben, es zusammenzufassen.
Halten Sie die gesamte Pipeline offline
Die meisten privaten RAG-Projekte existieren genau deshalb, weil das Material nicht an Dritte weitergegeben werden kann. Es lohnt sich, darauf zu achten, wenn der Konvertierungsschritt stillschweigend diese Regel bricht: Die Verwendung eines web-basierten Konverters zur Vorbereitung von Dokumenten für ein System, dessen ganzer Zweck Vertraulichkeit ist, ist ein Widerspruch, der tendenziell bestehen bleibt, weil die Konvertierung eher als technische Infrastruktur denn als Verarbeitung behandelt wird.
Ein lokaler Desktop-Konverter hält die Nachverfolgungskette von der .sam-Datei bis zum Vektorspeicher intakt. Es wird nichts übertragen, sodass es keinen Transfer gibt, der bewertet oder dokumentiert werden muss, und die Pipeline kann auf einer isolierten Workstation ausgeführt werden, wenn dies das Material erfordert.
Kombinieren Sie dies mit einem lokalen Embedding-Modell und einer selbst gehosteten Vektor-Datenbank, und Sie haben ein System, das Sie in einer Compliance-Prüfung ehrlich beschreiben können: Der Korpus hat das Netzwerk zu keinem Zeitpunkt verlassen.
Warum Markdown zuerst für RAG besser ist als PDF zuerst
- Überschriften bleiben als Struktur erhalten, sodass das Chunking der Logik des Dokuments folgt
- Tabellen behalten die Zuordnung von Kopfzeile zu Wert, die bei der PDF-Extraktion verloren geht
- Formeln kommen als LaTeX an – durchsuchbar und maschinenlesbar statt als Bilder
- Kein OCR- oder Layout-Rekonstruktionsschritt, also weniger Tokens und weniger Rauschen
- Die gesamte Pipeline bleibt offline und wahrt die Vertraulichkeit, die sie überhaupt erst begründet hat
Jahrzehnte an Kontext, endlich abfragbar
Die wertvollsten Dokumente in einer Organisation sind oft die ältesten, weil sie festhalten, warum die Dinge so sind, wie sie sind. Wenn man sie in einem Format lässt, das niemand lesen kann, bedeutet das, dass Ihr KI-System die Gegenwart kennt, aber keinen der dahinterliegenden Gründe.
Konvertieren Sie das Archiv in Markdown mit den angewendeten Stylesheets, nach Überschriften aufgeteilt, mit Daten und Abteilungen gekennzeichnet, lokal eingebettet, und sagen Sie dem Modell, ausdrücklich anzugeben, wie alt seine Quellen sind. Das Korpus wird von unsichtbar zu durchsuchbar, und es verlässt niemals Ihr Netzwerk.
Dateien konvertieren
Weiterführende Artikel
Machen Sie Ihr Ami Pro-Archiv KI-lesbar
Die kostenlose Testversion konvertiert bis zu 10 .sam Dateien in Markdown mit LaTeX-Gleichungsextraktion — testen Sie Ihre Aufteilung, bevor Sie sich auf das gesamte Korpus festlegen.
Kostenlose Testversion
Alle App-Funktionen — bis zu 10 Dateien
Windows 10 oder 11
Laden Sie den Windows-Installationsprogramm für die vollständige 10-Dateien-Testversion herunter. Dieselbe App, die Sie mit einer Lizenz freischalten — 100 % lokal auf Ihrem PC.